15-(入侵) 进程的地址空间

15-(入侵) 进程的地址空间

状态机里有什么

registers

memory

gdb就可以暂停查看

1
fa1e0ff3
1
f3 0f 1e fa

在内存中显示以小端为首

地址空间是否可读写

在proc/pid/maps里都给出了,连续的一段一段的,每一段都给出了权限

1
2
3
4
5
564af047d000-564af0494000 r--p 00000000 08:20 31005                      /usr/bin/zsh
564af0494000-564af0552000 r-xp 00017000 08:20 31005 /usr/bin/zsh
564af0552000-564af056d000 r--p 000d5000 08:20 31005 /usr/bin/zsh
564af056d000-564af056f000 r--p 000ef000 08:20 31005 /usr/bin/zsh
564af056f000-564af0575000 rw-p 000f1000 08:20 31005 /usr/bin/zsh

更可读

1
pmap [pid]

创建不同的数组,分配的内存是不一样的

在栈上,在堆上,

不进入内核的系统调用gettimeofday(2)

从操作系统读数据

只有syscall指令可以改变地址空间(增删改)

看看man 5 proc手册

mmap可以分配内存,控制权限

python执行时遇到ModuleNotFoundError: No module named 'hexdump'0

原因是sudo执行时的环境变量不一样

wsl显示全为0

gdb调试,可以把要调试的程序的内存空间放进自己的内存空间

变速齿轮

hook,劫持相关代码
16-系统调用和 UNIX Shell (pipe; xv6 shell)

16-系统调用和 UNIX Shell (pipe; xv6 shell)

虚拟化,syscall

操作系统对象:文件和设备,

指针只能指向程序的内存空间

指向操作系统对象的指针(就是文件描述符),在linux中everything is a file

访问对象用指针open, close,read/write(解引用),lseek,dup等

复习指针

windows中文件描述符时handle,句柄

管道,IPC

写口,读口

管道是进程之间的同步机制

通信不仅可以用来传送数据,还可以用来同步

匿名管道

1
pipefd[0] refers to the read  end  of the  pipe.  pipefd[1] refers to the write end  of the  pipe.

fork复制时,管道也被复制了

指针也完成了浅拷贝

shell连接I/O设备和人

<(command)把命令变成文件

ctrl + z切换后台

jobs查看后台,fg %1切换后台到前台

shell可以调用syscall

19-可执行文件:静态链接和加载

19-可执行文件:静态链接和加载

execve(加载)把当前的进程重置成指定可执行文件的初始状态

可执行文件:一个状态机初始状态的数据结构

里面规定了加载该可执行文件后地址空间里该有什么数据(寄存器,代码段等)

状态:内存和寄存器

elf为了性能丧失了阅读友好性

magic number是什么

Magic number一般是指硬写到代码里的整数常量,数值是编程者自己指定的,其他人不知道数值有什么具体意义,表示不明觉厉,就称作magic number。

a.out

设计一个可读的可执行文件,需要什么(代码,符号,重定位)

FLE 加载器:只做一件事

  • 将一段字节序列复制到地址空间中
    • 赋予可读、可写、可执行权限
  • 然后跳转到 _start 执行

ELF 并没有多做多少

  • 将多段字节序列复制到地址空间中
    • 分别赋予可读/可写/可执行权限
  • 然后跳转到指定的 entry (默认为 _start) 执行

#!/bin/bash

1
2
#!A B C
THIS

argc[0] = A

argv[1] = B C

argv[2]该 程序的名称

20-动态链接和加载

20-动态链接和加载

libc.o静态链接

容易浪费空间

libc.so动态链接

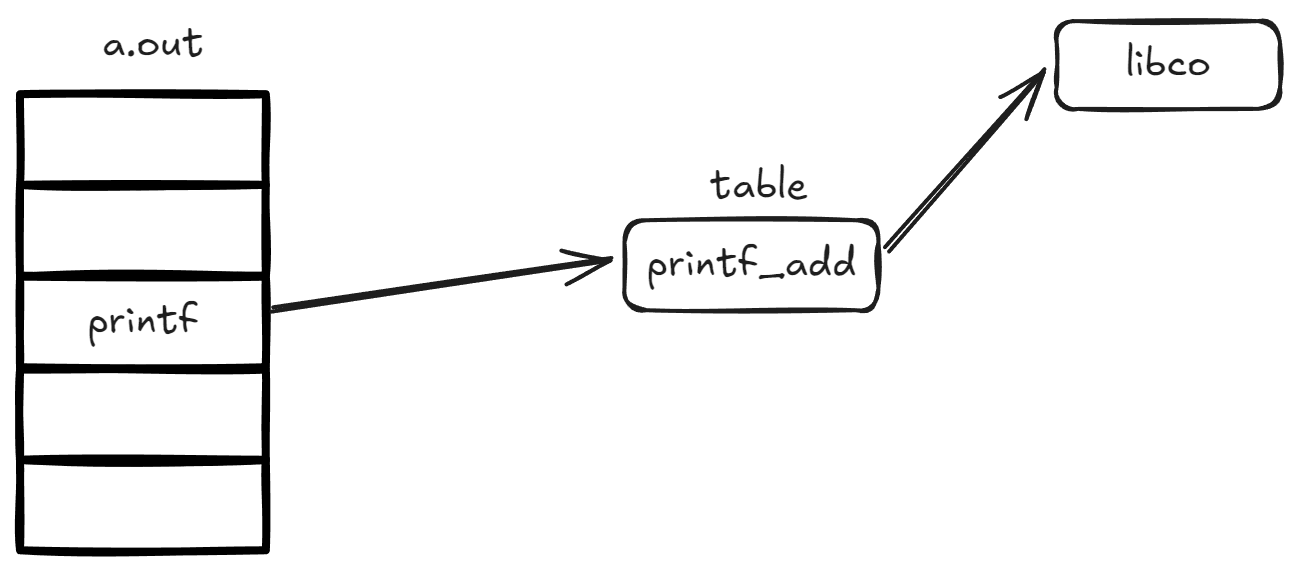
生成位置无关代码,使用中间的table存放函数地址

借助编译器完成

用多个线程链接库,验证只有一个副本

是链接的同一份

地址空间是怎么分配的(虚拟内存)

动态链接(查表)

image-20241207160836673

编译时,函数调用 = 查表(把函数调用替换成查表)

编译时,动态链接库调用 = 查表

1
call  *TABLE[printf@symtab] 

链接时,收集所有符号,“生成” 符号信息和相关代码:

1
2
3
4
5
6
7
8
9
#define foo@symtab     1
#define printf@symtab 2
...
void *TABLE[N_SYMBOLS];
void load(struct loader *ld) {
TABLE[foo@symtab] = ld->resolve("foo");
TABLE[foo@printf] = ld->resolve("printf");
...
}

image-20241208152058135

1
2
3
4
5
LOAD("libc.dl")
LOAD("libhello.dl")
IMPORT(hello)
IMPORT(exit)
EXPORT(_start)

gdb过程dlbox main.s

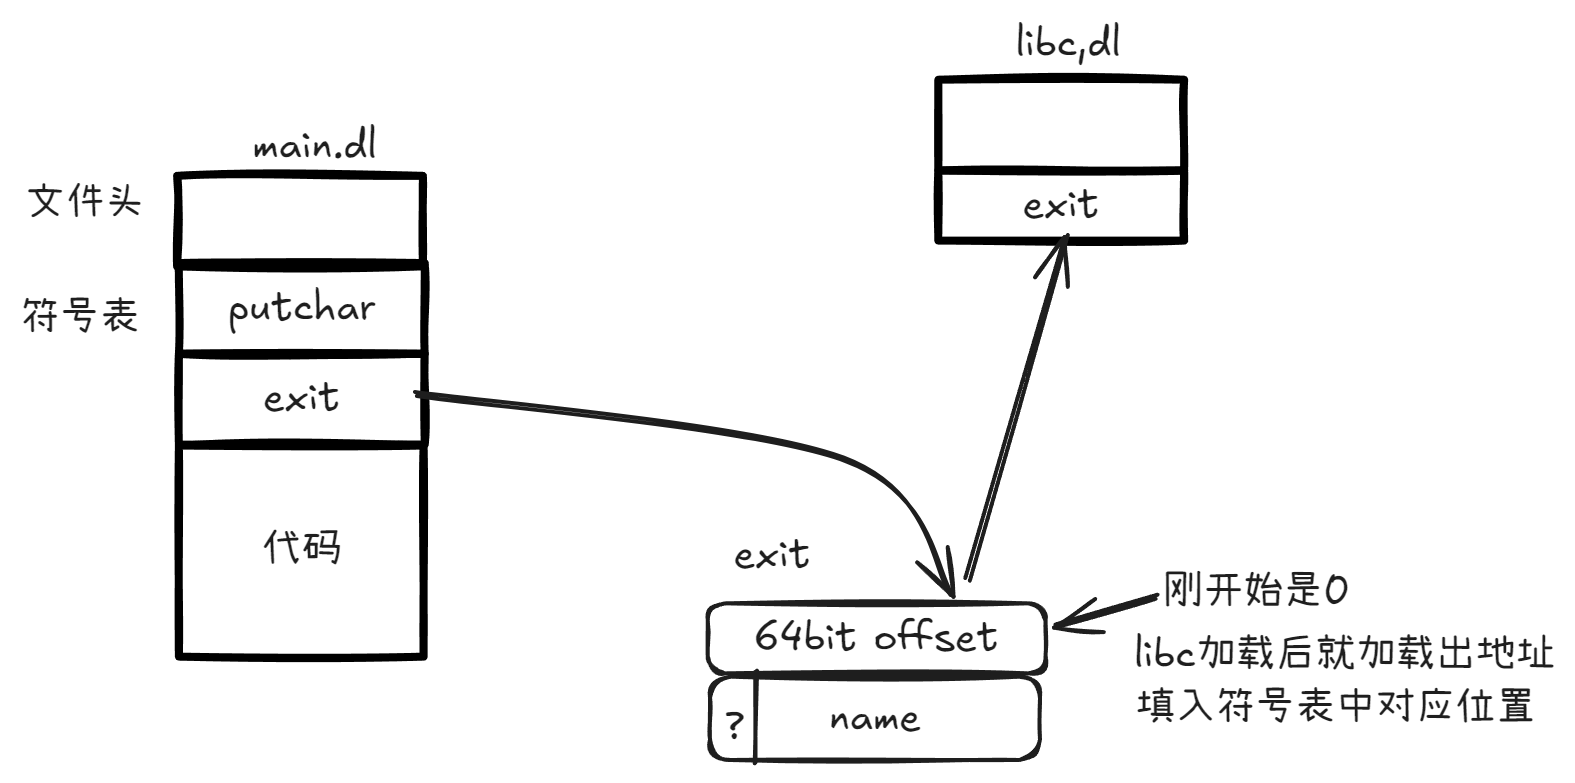
加载符号表,递归调用dlopen,调用libc.dl,导出符号,

putchar,exit填到全局的符号表,

解析第二个符号,libhello.dl

….

动态解析hello,hello不在main.dl里,是?

调用dlsym检查符号表,找到hello把地址填入符号表

执行DSYM(exit)

1
#define DSYM(sym)   *sym(%rip)

找到空位把符号填入符号表

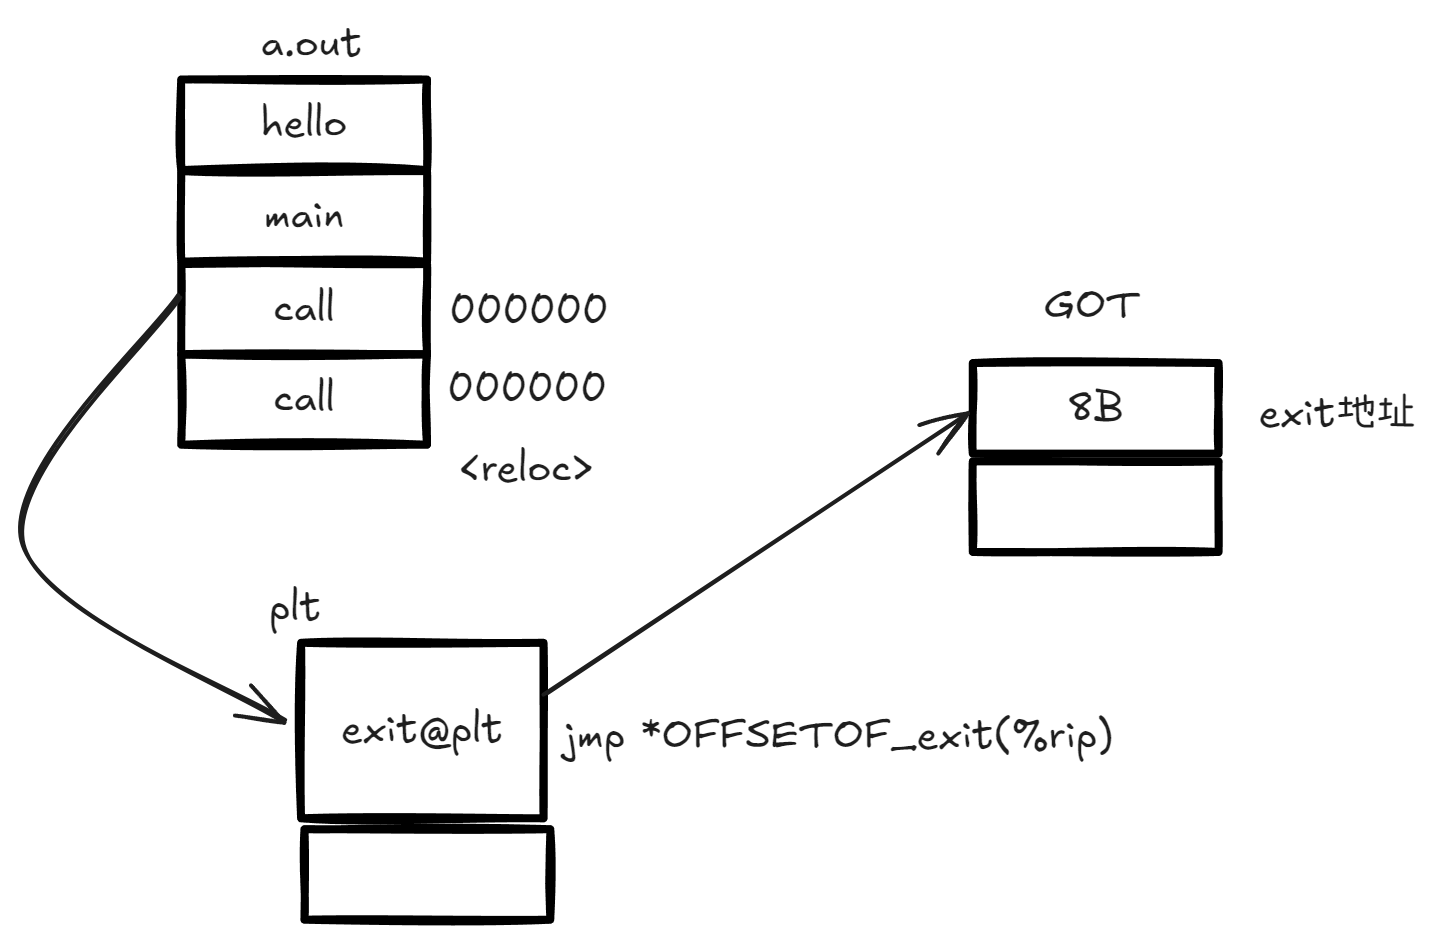
前面的存放地址和函数名的表项,就是 GOT (Global Offset Table)

因为call 的偏移量是64位,跳不到远处

所以使用plt,作为中转,先跳到plt中,plt中存放GOT对应函数的地址

再次跳转到对应函数

image-20241208121223400

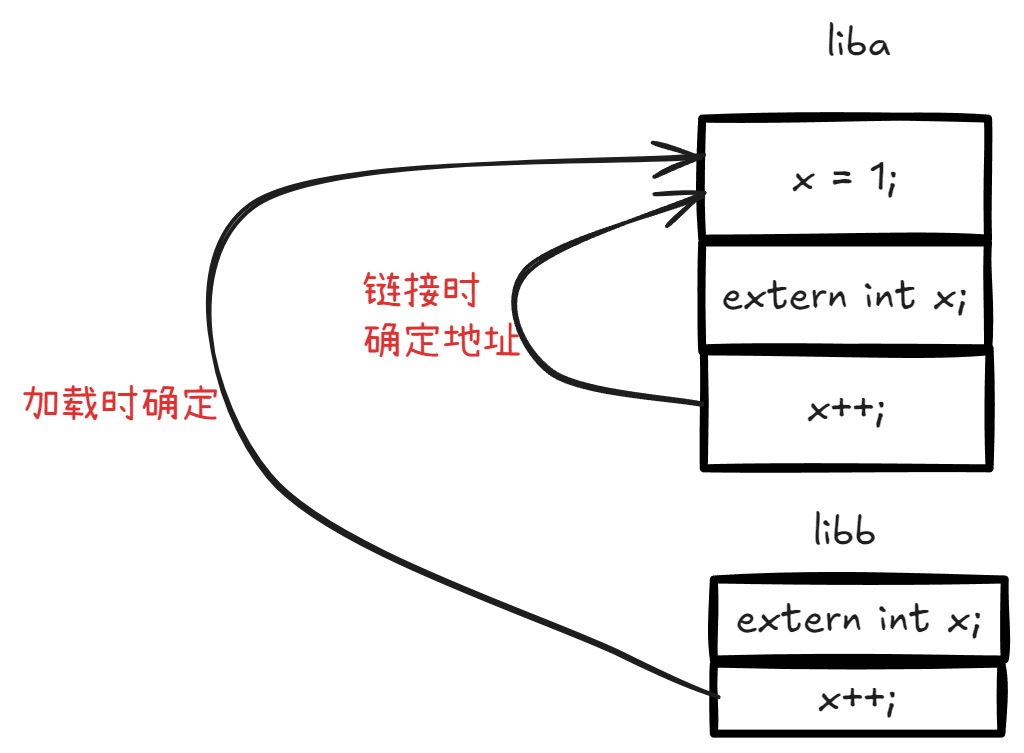
数据的链接,plt怎么解决数据链接的问题

image-20241208171116351

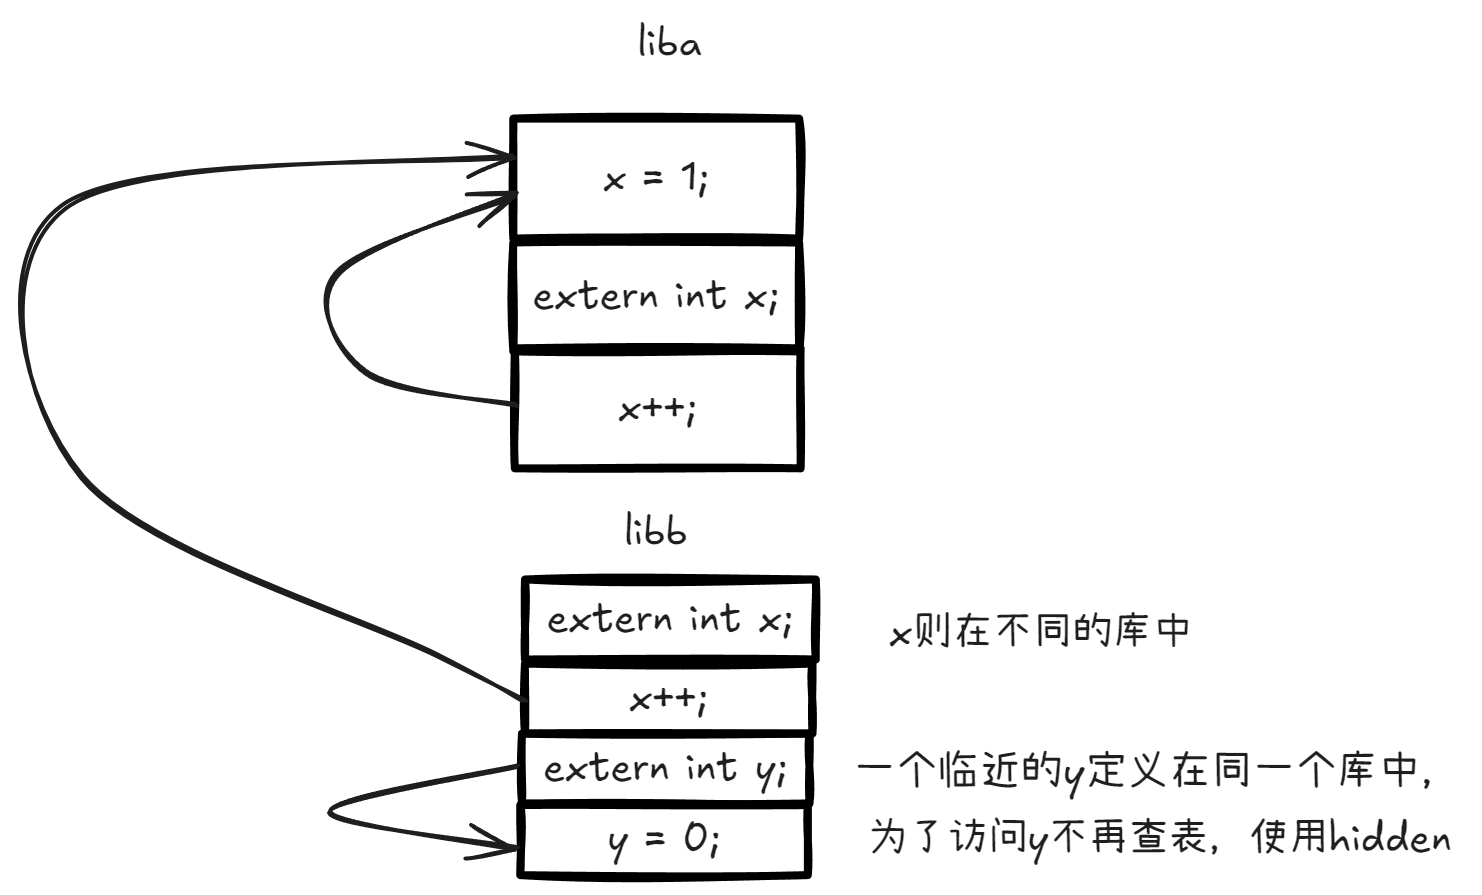
get_x会查表

get_y直接得到地址(hidden)

编译器默认extern变量来自另外一个共享库单元(保守)

image-20241208181848498

gpt对objdump反汇编的分析

总结

  1. 变量 x:
    • 默认可见性(visibility("default"))。
    • 使用 mov 指令,通过符号表获取地址。
    • 可被其他模块或共享库访问。
  2. 变量 y:
    • 隐藏可见性(visibility("hidden"))。
    • 使用 lea 指令,直接计算地址,无需符号表查找。
    • 仅在当前模块内部可见,无法被外部访问。
  3. 性能影响:
    • 隐藏符号(y)链接效率更高,因为不需要符号表查找。
    • 默认可见性符号(x)灵活性更强,但动态链接时可能会引入额外开销。

21-系统调用、中断和上下文切换

21-系统调用、中断和上下文切换

动态链接,stderr和int x的调用

处理器和中断

中断和系统调用都是跳转到某段操作系统代码

syscall的代码顺带关中断,节省一条指令

与掩码(MASK)相与可以清零指定位

22-进程的实现 (虚拟地址空间;UNIX 和 xv6)

22-进程的实现 (虚拟地址空间;UNIX 和 xv6)

1024叉树

32bit,10bit+10bit+12bit,12bit放访问信息

一个4KB页面,一个放一个4B的指针,总共2^1024

绝大部分节点都是空的,下一层也类似(局部性原理)

64bit,4KB的页面,一项8B,总共有512项,不是很整齐

映射不需要先载入,只需要一个数据结构记录访问权限

到用指针访问时,发生缺页中断,如果合法访问,则改变f,映射一页

指针单点访问地址空间,一段时间后就能记录哪里能访问,哪里不能访问,把不能访问的释放掉,放到磁盘上

swap机制,闲置页面放到磁盘上,释放内存

可以使所有进程使用的内存总和比物理内存大

fork系统调用

fork() 在进行状态机复制时,虽然理论上需要做出完整的状态复制,但本着 “复制的数据可能立即被浪费掉” 的观察,操作系统希望只在 “不得不复制” 时才复制。

现代操作系统会维护页面的共享情况,并在 fork 后将父子进程的地址空间都标记为 read-only,而当双方中的任何一个进程写入发生 page fault 时,才复制一页。对于连续的 fork(),则会产生多个进程共享页面的情况。

服务器的容错,可以用fork以很小的代价做快照

23-处理器调度 (xv6 上下文切换;处理器调度:机制和策略)

23-处理器调度 (xv6 上下文切换;处理器调度:机制和策略)

由用户态,执行syscall

跳转到内核态代码,寄存器保存,切换页表和栈

调度策略

1
taskset -c 3 nice -n 19 yes > /dev/null & taskset -c 3 nice -n 9 yes > /dev/null 

nice值相差10,占用cpu时间相差1倍

上下文切换是机制,策略是选择哪个进程执行

动态优先级,CPU密集型的优先级逐渐降低,交互型的优先级逐渐增加

动态优先级实现的虚拟时间是什么原理,为什么“好人”和“坏人”会相差几倍

进程的nice值越小(优先级越高),权重越大,在实际运行时间相同的情况下,虚拟运行时间越短,进程累计的虚拟运行时间增加得越慢,在红黑树中向右移动的速度越慢,被调度器选中的机会越大,被分配的运行时间相对越多。随着优先级高进程的虚拟运行时间增长,低优先级的进程也会有机会被调度

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
/*
* Nice levels are multiplicative, with a gentle 10% change for every
* nice level changed. I.e. when a CPU-bound task goes from nice 0 to
* nice 1, it will get ~10% less CPU time than another CPU-bound task
* that remained on nice 0.
*
* The "10% effect" is relative and cumulative: from _any_ nice level,
* if you go up 1 level, it's -10% CPU usage, if you go down 1 level
* it's +10% CPU usage. (to achieve that we use a multiplier of 1.25.
* If a task goes up by ~10% and another task goes down by ~10% then
* the relative distance between them is ~25%.)
*/
static const int prio_to_weight[40] = {
/* -20 */ 88761, 71755, 56483, 46273, 36291,
/* -15 */ 29154, 23254, 18705, 14949, 11916,
/* -10 */ 9548, 7620, 6100, 4904, 3906,
/* -5 */ 3121, 2501, 1991, 1586, 1277,
/* 0 */ 1024, 820, 655, 526, 423,
/* 5 */ 335, 272, 215, 172, 137,
/* 10 */ 110, 87, 70, 56, 45,
/* 15 */ 36, 29, 23, 18, 15,
};

Linux CFS调度器 vruntime 的计算_linux vruntime-CSDN博客

CFS,完全公平调度,记录每个进程运行时间,每次都切换到运行时间最少的进程。

红黑树

6.s081debug kernel

6.s081debug kernel

在vscode配置好后无法debug用户程序,不能打断点

在debug console执行-exec file user/_ls

qemu-gdb debug指南之can not access memory解决! - 知乎 (zhihu.com)

当你的xv6 kernel已经运行起来的时候, 你想往一个用户程序打断点,你只能先加载他的符号表,然后将断点打在main函数的入口,然后在xv6 调用该程序,触发main函数断点,然后才可以在任意一行打断点。记住顺序不能乱。

解决方案,先暂停程序,然后在debug console中输入

1
-exec file user/_ 

加载该程序文件,然后打断点,运行程序debug