多线程

多线程

独立的栈,共享的内存空间

阅读thread.h源码

在thread-qa中

将thread.h移入文件夹,执行make报错找不到库

解决方法:设置TLIB_PATH路径为thread.h所在的文件夹

1
CFLAGS := -O1 -g -I$(TLIB_PATH)

解释

  1. -I$(TLIB_PATH):
    • 这个选项指定了一个包含路径,该路径由 $(TLIB_PATH) 变量定义。
    • $(TLIB_PATH) 可能在 Makefile 的其他地方定义,或者在运行 make 命令时通过环境变量传递。
    • 编译器会在 $(TLIB_PATH) 指定的目录中查找头文件。
  2. -I.:
    • 这个选项指定当前目录(.)作为包含路径。
    • 编译器会在当前目录中查找头文件。

多个进程读取写入

支付宝,第一个减去100,第二个在该进程没有减去的时候进行条件判断,也减去100,由于是unsigned long 结果变成很大的数

copilot解释

竞态条件的发生

  1. 共享变量:balance 是一个全局变量,多个线程可以同时访问和修改它。
  2. 线程创建:main 函数中创建了两个线程,分别执行 T_alipay 函数。
  3. 函数调用:每个线程调用 Alipay_withdraw(100),尝试从 balance 中扣除 100。

竞态条件的具体过程

  1. 线程1和线程2同时检查 balance:

    • 线程1检查 balance 是否大于等于 100,结果为真。
    • 线程2也检查 balance 是否大于等于 100,结果也为真。
  2. 线程1和线程2同时进入 if 块:

    • 线程1进入 if 块并调用 usleep(1),暂时让出CPU。
    • 线程2也进入 if 块并调用 usleep(1),暂时让出CPU。
  3. 线程1和线程2同时修改 balance:

    • 线程1从 balance 中减去 100,balance 变为 0。
    • 线程2也从 balance 中减去 100,balance 无符号整数会溢出

如果是两个进程都循环加1加到10000,结果不会是20000

原代码反汇编

1
2
3
4
13ea:       48 8b 05 4f 2c 00 00    mov    0x2c4f(%rip),%rax       
# 4040 <sum>
13f1: 48 83 c0 01 add $0x1,%rax
13f5: 48 89 05 44 2c 00 00 mov %rax,0x2c44(%rip)

修改成一条汇编指令

1
13ea:       48 ff 05 4f 2c 00 00    incq   0x2c4f(%rip)  

改成一条指令,如果在一个处理器上还能正确,但是在多处理器上还会错误。

看着是一条指令,实际上不是原子指令。

printf是线程安全的

因为汇编指令取值,在中间寄存器加1后可能会中断,再放入变量对应地址中,结果可能就只是加一个1,而不是两个1

最小可以小于10000,可以改成汇编指令

为什么是2?

每个进程有一个n次循环,n个进程

在关键进程中,最后一步store,之前,已经循环了n-1次了,这两次的最小值为1(进程A第一个循环store()时,关键进程第n-1个循环正好结束,进程A,store后sum=1)关键进程执行前两步,然后关键进程等待其他进程结束后执行store(2,sum)

编译器优化,可能会隐藏并发的bug(都假设状态迁移是原子性,顺序执行)

O1优化sum=100000000

1
2
3
load(sum + N)
;循环N次
store(num)

O2优化sum=200000000

1
2
3
0000000000001260 <T_sum>:
1264: 48 81 05 d1 2d 00 00 addq $0x5f5e100,0x2dd1(%rip)
;改成了一条指令,两个进程碰在一起的概率很低

处理器也是编译器,所以单线程的处理器可能会优化,调换程序执行的顺序(在结果不变的情况下)

也是状态机,流水线,读写不冲突就能同时执行

所以……相对论?

共享内存只是一个简化的假象

mem-modle

一个是写Y读X,一个是写X读Y,得按特定顺序才能输出1,1,所以很少

arm与x86的内存模型不同,对于多线程的程序模拟难度大
实现库函数printf

实现库函数printf

1
int    printf    (const char *format, ...);

这个程序除了调用的库函数不同 (例如没有 stdio.h;多了 am.h) 之外,它就是一个完全符合 C 标准的普通程序,但因为没有操作系统和标准库的支持,我们需要编写所有的库函数。例如,printf 也来自我们的代码,它调用了 AbstractMachine 提供的 putch API:

嵌套类

Club嵌套Coach

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Coach{
string name;
int winRate;
public:
Coach(string n, int wr){
name=n; winRate=wr;
}
void show();
};
class Club{
string name;
Coach c;
int year;
public:
Club(string n1, int y, string n2, int wr);
void show();
};

Club的初始化和show函数要利用Club类中的东西

1
2
3
4
5
6
7
8
Club::Club(string n1,int y,string n2,int wr):c(n2,wr){
name = n1;
year = y;
}
void Club::show(){
cout << name << " " << year << "\n";
c.show();
}

同样,在下面Circle调用内部Point类型的变量,要有Point中的get函数配合才能取出相应的x,y

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#include<bits/stdc++.h>
using namespace std;
class Point{
private:
double x,y;
public:
Point(int n,int m):x(n),y(m){}
double get_x(){return x;}
double get_y(){return y;}
};
class Circle{
private:
Point o;
double r;
public:
Circle(Point p,double x):o(p){r = x;}
bool isPointIn(Point p){
double a = o.get_x();
double b = o.get_y();
double c = p.get_x();
double d = p.get_y();
double x = sqrt((a - c) * (a - c) + (b - d) * (b - d));
if(x < r)return true;
return false;
}
};

并发问题

该例子是一个生产者一个消费者,缓冲区是1,如果缓冲区很大这个问题就会被忽视了,如果生产者和消费者数量增加,那么死锁概率也会增加

1
2
3
4
5
6
7
8
9
10
11
12
13
14
//错误的
void wait(struct condvar *cv, mutex_t *mutex){
mutex_lock(&cv -> lock);
cv -> nwait++;
mutex_unlock(&cv -> lock);
//理想状态是球在生产者和消费者之间传递
mutex_unlock(mutex);
//但是如果在这里broadcast抢占,先唤醒了,然后nwait=0了,
//就相当于唤醒了另一个同样是生产者或者是消费者线程甚至是自己把球抢走了,再检查条件再进入wait,但是没有线程再放球了就会死锁
P(&cv -> sleep);//这个睡眠和解锁顺序不能更改


mutex_lock(mutex);
}

问题是,为什么前一个线程执行完的broadcast后,consumer(12896)为什么没被唤醒,而后面的producer(12897)被唤醒了,而且例子中只有一个生产者和一个消费者,缓冲区大小为1

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
------Consumer: begin, execution count: 12896------
Consumer: Waiting
------waiting------
in wait nwait: 1
waiting before sleep

------Producer: begin, execution count: 12896------
(
depth = 1
Producer: Broadcast
------broadcast_start------
start broadcast
int broadcast nwait: 1
------broadcast_end------
------Producer: end, execution count: 12896------

------Producer: begin, execution count: 12897------
Producer: Waiting
------waiting------
in wait nwait: 1
waiting before sleep
------waiting out------
Producer: Waiting
------waiting------
in wait nwait: 2
waiting before sleep

标准C++类stdstring的内存共享和Copy-On-Write技术

标准C++类std::string的内存共享和Copy-On-Write技术_std::string重新分配内存拷贝字符串-CSDN博客

string的懒拷贝

当函数返回一个静态字符串时,这个字符串存储在函数的静态存储区域中。这个静态存储区域在程序的整个生命周期内都存在,并且在程序加载时分配,在程序退出时释放。

在你描述的情况中,函数GetIPAddress返回一个静态字符串,它在动态链接库的地址空间中分配。当动态链接库被释放时,这个地址空间也被释放,导致返回的静态字符串指向的内存变得无效。但是,由于字符串对象的值是存储在这个无效内存中的,所以在后续程序中使用这个字符串时就会出现未定义行为,因为访问了无效的内存地址。

这种情况下,即使程序在后续没有使用到这个字符串,当程序退出时,会调用字符串对象的析构函数,尝试释放这个无效内存,进而导致内存访问异常,导致程序崩溃。

模板的全特化与偏特化

模板的全特化与偏特化

模板函数和模板类有的时候可能需要对传入的不同类型进行不同的处理,比如说有的模板传入int或double类型都可以处理,但是传入char型则会出错,这时就需要模板特化的方式。

类模板全特化:

全特化即将模板类型里的所有类型参数全部具体指明之后处理,如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
template<typename T,typename C>
struct A
{
A(){cout<<"泛化版本构造函数"<<endl;}
void func()
{
cout<<"泛化版本"<<endl;
}
};

template<>//把类型取出
struct A<int,int>
{
A(){cout<<"int,int特化版本构造函数"<<endl;}
void func()
{
cout<<"int,int特化版本"<<endl;
}
};

template<>中为空,代表所有类型都在下面特殊化处理,上面相当于对int,int进行了分别的处理,其他类型依然是泛化版本。

对类中的某个成员函数进行特化处理

还是以上面给的例子为基础,特化func()成员函数,当A的模板参数为<int,double>时,调用特化版的func()。

1
2
3
4
5
template<>
void A<int,double>::func
{
cout<<"int,double特化版本函数"<<endl;
}

类模板的偏特化

类模板偏特化(局部特化):顾名思义,只特殊化几个参数或者一定的参数范围

个数偏特化

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
template<typename T,typename C,typename D>
struct A
{
void func()
{
cout << "泛化版本" << endl;
}
};

template<typename C>
struct A<int,C,int>
{
void func()
{
cout << "int,C,int偏特化版本" << endl;
}
};

template<>括号中存留的参数是依然可以任意填的参数。

STL中的一个个数偏特化例子:

1
2
3
//泛化
template <class T,class Alloc = alloc>
class vector{}
1
2
3
4
//特化
template <class Alloc>
class vector<bool, Alloc>
{};

范围偏特化

记住这种情况的template<>中还是要填上原有的大类型,且const T*属于T*不属于const T。

注意范围二字,比如const int属于int的一个小范围,int *和const int*属于int的一个小范围,int&属于int的一个小范围,int&&属于int的一个小范围

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
template<typename T>
struct A
{
void func()
{
cout << "泛化版本" << endl;
}
};

template<typename T>
struct A<const T>
{
void func()
{
cout << "const T版本" << endl;
}
};

template<typename T>
struct A<T*>
{
void func()
{
cout << "T*版本" << endl;
}
};

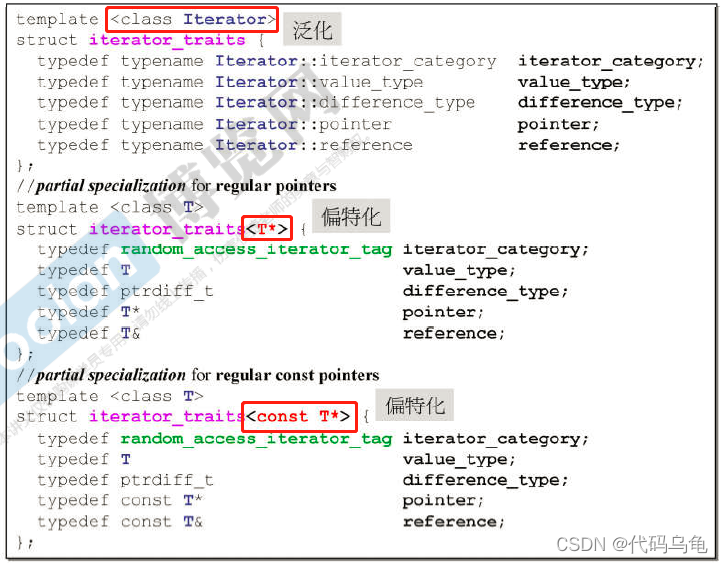
STL中的一个范围偏特化例子:
在这里插入图片描述

调试

理解状态机执行:不是 “调试”,也是 “调试”

  • ssh:使用 -v 选项检查日志
  • gcc:使用 -v 选项打印各种过程
  • make:使用 -nB 选项查看完整命令历史

调试:不仅是 “调试器”

  • Profiler: perf - “采样” 状态机
  • Trace: strace - 追踪系统调用

将日志文件重定向到vim进行各种操作

1
strace -f g++ a.cc |& vim -

执行 grep 命令进行过滤,可以通过 :! 来运行外部命令并将结果显示在 vim 中。

步骤如下:

  1. 在 vim 中输入:

    1
    :!grep "关键词" 文件名

    或者,你可以直接对 vim 缓冲区的内容使用管道进行过滤:

    1
    :%!grep "关键词"
    • :!grep "关键词":会在当前终端执行 grep,但不影响你在 vim 中的内容。
    • :%!grep "关键词":会将当前文件内容通过管道传递给 grep,然后将过滤结果替换当前文件的内容。
  2. 例如:

    1
    :%!grep "error"

    这会将所有包含 error 的行保留,并替换掉当前缓冲区的内容。

如果包含.h这种,使用转义字符

1
:%!grep "\.h"

调试bootloader

gdb调试

目的:复现jyy的调试过程

直接执行make debug会报错,显示no file问题就是boot里的文件是bootblock.o而不是boot.o,所以在其Makefile里添加

1
cp bootblock.o boot.o

复制一份,如何就再次执行make debug 就会出现新的bug

1
gdb.error: "/home/cgz/work/os-workbench/abstract-machine/am/src/x86/qemu/boot/boot.o": not in executable format: file format not recognized

显示格式不能识别,问gpt回答为该种格式不能直接调试,需要启动qemu,连接调试,事实也是这样,

问题不是这个。所以就是Makefile里缺少-ggdb

需要-ggdb提供调试信息,gdb才能调试可执行文件

在

1
abstract-machine/am/src/x86/qemu/boot/Makefile

添加-ggdb可以同时解决打印不出来的问题,不实现stdio里的printf函数也能打印

设置$AM_HOME为pa的框架,改写Makefile不起作用

但是改写为直接clone的

1
/home/cgz/work/os-workbench/abstract-machine/am/src/x86/qemu/boot/Makefile

就能正常使用printf,但是用make debug还是没有标记

1
gdb.error: "/home/cgz/work/os-workbench/abstract-machine/am/src/x86/qemu/boot/boot.o": not in executable format: file format not recognized

造成这个的原因是在文件上没有gdb可以识别的标记

解决方法应该是加上-ggdb应该就可以

但是还是报错没有标记,把bulid生成的.o文件全部删除,再执行也一样。

尝试把py程序代码手动输入,看看能否解决

1
2
3
4
debug:
qemu-system-i386 -s -S -machine accel=tcg -smp "1,sockets=1" \
-drive format=raw,file=build/hello-x86-qemu &
gdb -x debug.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# Register the quit hook
def on_quit():
gdb.execute('kill')

gdb.events.exited.connect(on_quit)

# Connect to the remote target
gdb.execute('target remote localhost:1234')

# Load the debug symbols
am_home = os.environ['AM_HOME']
path = f'{am_home}/am/src/x86/qemu/boot/boot.o'
gdb.execute(f'file {path}')

# This is the 0x7c00
gdb.Breakpoint('_start')

# This is where 32-bit code starts
gdb.Breakpoint('start32')

# Continue execution
gdb.execute('continue')

提取出命令

1
2
3
4
5
6
7
8
9
10
11
qemu-system-i386 -s -S -machine accel=tcg -smp "1,sockets=1" -drive format=raw,file=build/hello-x86-qemu &
//打开虚拟机文件夹
gdb am/src/x86/qemu/boot/boot.o

target remote localhost:1234

//然后打断点执行
(gdb)b _start
(gdb)b start 32
(gdb)c

同样的报错

已解决

把Makefile的两行交换位置即可

1
2
3
4
5
6
7
8
9
SRCS := start.S main.c
bootblock.o: $(SRCS) Makefile
@echo + CC $(SRCS)
@$(CROSS_COMPILE)gcc -ggdb -static -m32 -fno-pic -Os -nostdlib -Ttext 0x7c00 -I$(AM_HOME)/am/src -o bootblock.o $(SRCS)
cp bootblock.o boot.o
@python3 genboot.py bootblock.o#该pyhton程序的作用是将bootblock.o转换成其他格式供底层程序使用,破坏了其可调试性

clean:
rm -rf *.o

递归算法的时间复杂度

递归算法的时间复杂度

彻底搞懂递归的时间复杂度_递归排序的时间复杂度-CSDN博客

二分查找(Binary search):一般发生在一个数列本身有序的时候,要在有序的数列中找到目标数,所以它每次都一分为二,只查一边,这样的话,最后它的时间复杂度是O(logn)

二叉树遍历(Binary tree traversal):如果是二叉树遍历的话,它的时间复杂度为O(n)。因为通过主定理可以知道,它每次要一分为二,但是每次一分为二之后,每一边它是相同的时间复杂度。最后它的递推公式就变成了图中T(n)=2T(n/2)+O(1)这样。最后根据这个主定理就可以推出它的运行时间为O(n)。当然这里也有一个简化的思考方式,就是二叉树的遍历的话,会每一个节点都访问一次,且仅访问一次,所以它的时间复杂度就是O(n)

二维矩阵(Optimal sorted matrix search):在一个排好序的二维矩阵中进行二分查找,这个时候也是通过主定理可以得出时间复杂度是O(n),记住就可以了

归并排序(merge sort):所有排序最优的办法就是nlogn,归并排序的时间复杂度就是O(nlogn)

错误递归

错误递归

1
2
3
4
5
6
7
8
9
Polynomial& Polynomial::operator=(const Polynomial& p) {
if (this == &p) return *this;
delete[] coefficients;
size = p.size;
coefficients = new double[size];
for (int i = 0; i < size; i++)
coefficients[i] = p.coefficients[i];
return *this;
}
1
2
3
4
5
6
Polynomial& Polynomial::operator=(const Polynomial& p) {
if (this == &p) return *this;
delete[] coefficients;
*this = Polynomial(p);//重复调用了=
return *this;
}