python语法(2)

map/reduce

map()函数接收两个参数,一个是函数,一个是Iterable,

map将传入的函数依次作用到序列的每个元素,并把结果作为新的Iterator返回。

1
2
3
4
5
6
>>> def f(x):
... return x * x
...
>>> r = map(f, [1, 2, 3, 4, 5, 6, 7, 8, 9])
>>> list(r)#将惰性序列转换成list
[1, 4, 9, 16, 25, 36, 49, 64, 81]

reduce的用法。

reduce把一个函数作用在一个序列[x1, x2, x3, ...]上,

这个函数必须接收两个参数:函数还有被作用的序列

reduce把结果继续和序列的下一个元素做累积计算,其效果就是:

1
reduce(f, [x1, x2, x3, x4]) = f(f(f(x1, x2), x3), x4)

比方说对一个序列求和,就可以用reduce实现:

1
2
3
4
5
6
>>> from functools import reduce
>>> def add(x, y):
... return x + y
...
>>> reduce(add, [1, 3, 5, 7, 9])
25

filter过滤函数

filter()接收一个函数和一个序列。

把传入的函数依次作用于每个元素,

然后根据返回值是True还是False决定保留还是丢弃该元素

1
2
3
4
5
def not_empty(s):
return s and s.strip()

list(filter(not_empty, ['A', '', 'B', None, 'C', ' ']))
# 结果: ['A', 'B', 'C']

筛素数的方法,惰性筛选

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
def primes():
yield 2
it = _odd_iter() # 初始序列
while True:
n = next(it) # 返回序列的第一个数
yield n
it = filter(_not_divisible(n), it) # 构造新序列
#本质是每次it都叠加新的过滤规则,next出数之前都过滤
def _odd_iter():
n = 1
while True:
n = n + 2
yield n

def _not_divisible(n):
return lambda x: x % n > 0

迭代器后面的数根本没筛。

只是把“筛选规则”保存下来了。

等以后某个数字真正被生成时,再让它依次经过这些筛选规则。

例题,筛选回文数:

1
2
3
def is_palindrome(n):
s = str(n)
return s == s[::-1]#-1是倒序切片,s[::-1]表示将字符串s倒序排列
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def int2list(n):
list = []
while n > 0:
list.append(n % 10)
n //= 10 #整除符号
return list

def is_palindrome(n):
list = int2list(n)
if len(list) == 1 :
return True

for i in range(len(list) // 2):#整除到中间即可
if list[i] != list[-i - 1]:#0与-1比较
return False

return True

sort()

sorted()函数接收一个key函数来实现自定义的排序,例如按绝对值大小排序:

1
2
>>> sorted([36, 5, -12, 9, -21], key=abs)
[5, 9, -12, -21, 36]

key指定的函数将作用于list的每一个元素上,并根据key函数返回的结果进行排序。

1
2
3
list = [36, 5, -12, 9, -21]

keys = [36, 5, 12, 9, 21]

并按照对应关系返回list相应的元素:

1
result sort = [5, 9, -12, -21, 36]

要进行反向排序,不必改动key函数,可以传入第三个参数reverse=True

返回函数与闭包

注意到返回的函数在其定义内部引用了局部变量args,所以,当一个函数返回了一个函数后,其内部的局部变量还被新函数引用。

另一个需要注意的问题是,返回的函数并没有立刻执行,而是直到调用了f()才执行。

返回闭包时牢记一点:返回函数不要引用任何循环变量,或者后续会发生变化的变量。

如果一定要引用循环变量,

方法是再创建一个函数,用该函数的参数绑定循环变量当前的值,

1
2
3
4
5
6
7
8
9
def count():
def f(j):
def g():
return j*j
return g
fs = []
for i in range(1, 4):
fs.append(f(i)) # f(i)立刻被执行,因此i的当前值被传入f()
return fs

nonlocal

内层函数引用外层函数局部变量

只读则调用正常

赋值改写则会报错,要加nonlocal x声明

使用闭包时,对外层变量赋值前,需要先使用nonlocal声明该变量不是当前函数的局部变量。

匿名函数(lambda)

1
2
3
4
5
6
def f(x):
return x * x

lambda x: x * x

#lambda后面是参数,:后面是函数。只能有一个表达式,没用return,返回值就是表达式结果

匿名函数也可以作为返回值返回

装饰器Decorator

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
import functools

def log(func):
@functools.wraps(func)
def wrapper(*args, **kw):
print('call %s():' % func.__name__)
return func(*args, **kw)
return wrapper

@log
def now():
print('2015-3-25')

now()#相当于先调用wrapper里的打印日志,然后返回函数即now,然后执行

#输出
call now():
2015-3-25

三层嵌套,针对装饰器带参数的

1
2
3
4
5
6
7
8
9
10
import functools

def log(text):
def decorator(func):
@functools.wraps(func)
def wrapper(*args, **kw):
print('%s %s():' % (text, func.__name__))
return func(*args, **kw)
return wrapper
return decorator
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
@log("execute")
def now():
...

↓ 等价于

now = log("execute")(now)


第一层
log("execute")
│
│ text = "execute"
↓
返回 decorator
│
│
第二层 │ decorator(now)
│ func = 原来的 now
↓
返回 wrapper
│
│
↓
now = wrapper


之后调用:

now()
↓
wrapper()
│
├── 使用 text = "execute"
│
├── 使用 func = 原来的 now
│
└── func(*args, **kw)
↓
原来的 now()

经过decorator装饰之后的函数,它们的__name__已经从原来的'now'变成了'wrapper'

1
2
>>> now.__name__
'wrapper'

所以要加@functools.wraps(func)

偏函数

就是制作了一个有其他默认参数的函数

1
int2 = functools.partial(int, base=2)#默认转二进制

创建偏函数时,实际上可以接收函数对象、*args和**kw这3个参数

如果不些命名参数则就是位置参数

当传入:

1
max2 = functools.partial(max, 10)

实际上会把10作为*args的一部分自动加到左边,也就是:

1
max2(5, 6, 7)

相当于:

1
2
args = (10, 5, 6, 7)
max(*args)

结果为10。

模块

和java差不多,每一个包目录下面都会有一个__init__.py的文件

要注意:

  • 模块名要遵循Python变量命名规范,不要使用中文、特殊字符;
  • 模块名不要和系统模块名冲突,最好先查看系统是否已存在该模块,检查方法是在Python交互环境执行import abc,若成功则说明系统存在此模块。

作用域

类似__xxx__这样的变量是特殊变量,比如上面的__author__,__name__

类似_xxx和__xxx这样的函数或变量就是非公开的(private),不应该被直接引用,比如_abc,__abc等;

外部不需要引用的函数全部定义成private,只有外部需要引用的函数才定义为public。

python语法

列表

list可变,tuple不变

tuple定义

1
a = (1,)

条件判断

1
if x:

Python 会自动判断“真假”。

这些通常是假:

1
2
3
4
5
6
7
8
False
0
0.0
None
""
[]
{}
set()

其他大多数对象是真。

模式匹配

match

1
2
3
4
5
6
7
8
9
10
11
12
13
age = 15

match age:
case x if x < 10://age赋值给x并进行判断
print(f'< 10 years old: {x}')
case 10:
print('10 years old.')
case 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18:
print('11~18 years old.')
case 19:
print('19 years old.')
case _://和default一样
print('not sure.')

还可以直接拆对象列表

1
2
3
4
5
6
7
8
9
10
11
12
args = ["gcc", "hello.c", "world.c"]

match args:
case ["gcc"]:
print("没有源文件")

case ["gcc", file, *files]:
print(file)
print(files)

case ["clean"]:
print("clean")

循环

1
2
for i in range(10)://从0到9
print(i)
1
2
3
4
5
6
7
8
9
10
11
for x in iterable:
...

for i in range(10):
...

while condition:
...

break
continue

dict

1
2
3
Python dict
≈ Java HashMap
≈ C++ unordered_map
1
2
3
>>> d.get('Thomas')//不定义则返回None
>>> d.get('Thomas', -1)//查找失败自定义返回-1
-1

set

set和dict的唯一区别仅在于没有存储对应的value

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
定义
s = {1, 2, 3}
s = set([1,2,3])

s.add(4)
s.remove(2)

1 in s

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s1 & s2//交集
{2, 3}
>>> s1 | s2//并集
{1, 2, 3, 4}

set可以看成数学意义上的无序和无重复元素的集合

Tips:

空 set定义为:s = set()

不是:s = {}

因为:{}表示空字典。

可变/不可变对象

“可变 / 不可变” ≈ 对象本身能不能原地修改。

函数

可以返回多个值

1
2
3
4
def position():
return 10, 20

x, y = position()

看起来是两个返回值,其实:

1
return (10, 20)

返回的是 tuple。

所以理解为:

1
2
3
Python 多返回值
=
返回 tuple + 解包

参数

默认参数

定义默认参数要牢记一点:默认参数必须指向不变对象

1
2
3
def add_end(L=[]):
L.append('END')
return L
1
2
3
4
>>> add_end()
['END', 'END']
>>> add_end()
['END', 'END', 'END']

避免这种情况,让L指向不变对象

1
2
3
4
5
def add_end(L=None):
if L is None:
L = []
L.append('END')
return L

位置参数靠位置,关键字参数靠名字。

可变参数

可以直接使用*number

1
2
3
4
5
def calc(*numbers):
sum = 0
for n in numbers:
sum = sum + n * n
return sum

如果传入list或者tuple,也一样

1
2
3
>>> nums = [1, 2, 3]
>>> calc(*nums)
14

关键字参数

可传入参数名和参数值来组装成dict

传入的a=1,b=2这种形式是关键字参数

**kw是可变关键字参数,专门接收额外的关键字参数

1
2
3
4
def person(name, age, **kw):
print('name:', name,
'age:', age,
'other:', kw)
1
2
>>> person('Adam', 45, gender='M', job='Engineer')
name: Adam age: 45 other: {'gender': 'M', 'job': 'Engineer'}

**extra表示把extra这个dict的所有key-value用关键字参数传入到函数的**kw参数,kw将获得一个dict,注意kw获得的dict是extra的一份拷贝,对kw的改动不会影响到函数外的extra。

命名关键字参数

过滤不想接收的关键字参数

1
2
def person(name, age, *, city, job):
print(name, age, city, job)

如果函数定义中已经有了一个可变参数,后面跟着的命名关键字参数就不再需要一个特殊分隔符*了:

1
2
def person(name, age, *args, city, job):
print(name, age, args, city, job)
1
2
3
4
def f(a, *, b):
↑
单独的 *:
后面只能是关键字参数
1
2
3
4
5
def f(a, *args, b):
↑
*args:
既收集额外位置参数,
又自然把后面的 b 变成命名关键字参数

参数定义顺序

必选参数、默认参数、可变参数、命名关键字参数和关键字参数。

1
2
3
4
5
6
7
定义函数时:
*args → 收集位置参数,变成 tuple
**kwargs → 收集关键字参数,变成 dict

调用函数时:
*容器 → 拆成多个位置参数//所以传入的可以是(1,2,3)也可以是[1,2,3]
**dict → 拆成多个关键字参数

小结

Python的函数具有非常灵活的参数形态,既可以实现简单的调用,又可以传入非常复杂的参数。

默认参数一定要用不可变对象,如果是可变对象,程序运行时会有逻辑错误!

要注意定义可变参数和关键字参数的语法:

*args是可变参数,args接收的是一个tuple;

**kw是关键字参数,kw接收的是一个dict。

以及调用函数时如何传入可变参数和关键字参数的语法:

可变参数既可以直接传入:func(1, 2, 3),又可以先组装list或tuple,再通过*args传入:func(*(1, 2, 3));

关键字参数既可以直接传入:func(a=1, b=2),又可以先组装dict,再通过**kw传入:func(**{'a': 1, 'b': 2})。

使用*args和**kw是Python的习惯写法,当然也可以用其他参数名,但最好使用习惯用法。

命名的关键字参数是为了限制调用者可以传入的参数名,同时可以提供默认值。

定义命名的关键字参数在没有可变参数的情况下不要忘了写分隔符*,否则定义的将是位置参数。

切片

从序列里按“起点、终点、步长”取出一部分。

基本语法:

1
序列[start:end:step]

其中:

  • start:从哪里开始,包含
  • end:到哪里结束,不包含
  • step:每隔几个取一个
1
2
3
L = ['A', 'B', 'C', 'D', 'E']
L[1:3]
# ['B', 'C']

要点

1
2
3
[:end]     # 从开头到 end 前
[start:] # 从 start 到末尾
[:] # 全部

常见写法可以这样记:

1
2
3
4
5
6
L[:3]      # 前3个
L[2:] # 从索引2开始一直到最后
L[:] # 全部元素,相当于复制一份
L[::2] # 每隔一个取一个
L[::-1] # 倒序
L[-2:] # 最后2个

切片不只用于 list

tuple、str 也可以:

1
2
3
4
5
6
7
>>> (0, 1, 2, 3, 4, 5)[:3]
(0, 1, 2)

>>> 'ABCDEFG'[:3]
'ABC'
>>> 'ABCDEFG'[::2]
'ACEG'
1
2
3
4
5
6
7
8
9
10
11
12
1. 切片格式:[start:end:step]

2. start 包含,end 不包含
[1:4] → 取 1、2、3

3. start/end 可以省略
[:3] 前3个
[3:] 从3到最后

4. step 可以控制间隔和方向
[::2] 每隔一个取
[::-1] 倒序

迭代

默认情况下,dict迭代的是key。

如果要迭代value,可以用for value in d.values(),

如果要同时迭代key和value,可以用for k, v in d.items()。

列表生成式

1
[要放进列表的东西 for 元素 in 集合 if 筛选条件]
1
2
3
4
5
>>> [x * x for x in range(1, 11)]

>>> L = []
>>> for x in range(1, 11):
... L.append(x * x)

两个生成的都是

1
[1, 4, 9, 16, 25, 36, 49, 64, 81, 100]

for前面的if … else是表达式,而for后面的if是过滤条件,不能带else

顺序是:先筛选,再处理,再放入列表。

比如:

1
[x * 2 for x in range(10) if x % 2 == 0]

执行思路是:

1
2
3
for x in range(10):
if x % 2 == 0: # 先筛选
result.append(x * 2) # 再处理并放入列表

列表生成器

创建L和g的区别仅在于最外层的[]和(),

L是一个list

g是一个generator,保存的是算法,可使用next(g)调用下一个元素

也可使用for循环

1
2
3
4
5
6
7
def fib(max):
n, a, b = 0, 0, 1
while n < max:
yield b//直接使用yield就行,每次返回这个元素,next()继续从这个位置构造
a, b = b, a + b
n = n + 1
return 'done'
1
2
3
4
5
6
7
8
9
>>> for n in fib(6):
... print(n)
...
1
1
2
3
5
8

例题 杨辉三角

1
2
3
4
5
def triangles():#yield list t
t = [1]
while 1:
yield t
t = [1] + [t[i] + t[i+1] for i in range(len(t) - 1)] + [1]

迭代器

是数据流,也就是生成器还有带yield的生成器函数才是迭代器,未知长度只能不断通过next调用

虽然,如list、tuple、dict、set、str等可迭代

1
2
3
4
5
6
7
8
9
10
11
>>> from collections.abc import Iterable
>>> isinstance([], Iterable)
True
>>> isinstance({}, Iterable)
True
>>> isinstance('abc', Iterable)
True
>>> isinstance((x for x in range(10)), Iterable)
True
>>> isinstance(100, Iterable)
False

但是不是迭代器

可以使用isinstance()判断一个对象是否是Iterator对象:

1
2
3
4
5
6
7
8
9
>>> from collections.abc import Iterator
>>> isinstance((x for x in range(10)), Iterator)
True
>>> isinstance([], Iterator)
False
>>> isinstance({}, Iterator)
False
>>> isinstance('abc', Iterator)
False

生成器都是Iterator对象,但list、dict、str虽然是Iterable,却不是Iterator。

java笔记

规范

类名首字母大写

一个.java文件只能包含一个public类,但可以包含多个非public类。如果有public类,文件名必须和public类的名字相同

数据类型

对于整型类型,Java只定义了带符号的整型,因此,最高位的bit表示符号位(0表示正数,1表示负数)。各种整型能表示的最大范围如下:

类型 位数 最小值 最大值 2 的幂形式
byte 8 bit -128 127 $−2^7∼2^7−1$
short 16 bit -32768 32767 $-2^{15} \sim 2^{15}-1$
int 32 bit -2147483648 2147483647 $-2^{31} \sim 2^{31}-1$
long 64 bit -9223372036854775808 9223372036854775807 $-2^{63} \sim 2^{63}-1$

对于float类型,需要加上f后缀。

Java的char类型除了可表示标准的ASCII外,还可以表示一个Unicode字符:

引用类型类似指针

加final修饰变成常量

使用var自动推断变量类型,类似auto,让编译器根据右边的值自动推断变量类型。

与或非运算,|或 ,&与,~非,^异或

引用类型和字符串

null = 没有对象

** = 有一个字符串对象,但里面没有字符

字符串比较技巧,比较常量字符串和变量时可以这样,预防可能为null的情况

1
"-version".equals(arg)

可变参数

相当于数组类型

1
2
3
4
5
6
class Group {
private String[] names;
public void setNames(String... names) {
this.names = names;
}
}

传入null默认为数组类型String[]

1
g.setNames(null); ====  g.setNames((String[]) null);

构造方法

没有在构造方法中初始化字段时,引用类型的字段默认是null,数值类型的字段用默认值,int类型默认值是0,布尔类型默认值是false

一个构造方法可以调用其他构造方法,调用其他构造方法的语法是this(…)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Person {
private String name;
private int age;

public Person(String name, int age) {
this.name = name;
this.age = age;
}

public Person(String name) {
this(name, 18); // 调用另一个构造方法Person(String, int)
}

public Person() {
this("Unnamed"); // 调用另一个构造方法Person(String)
}
}

继承 is

在Java中,任何class的构造方法,第一行语句必须是调用父类的构造方法。如果没有明确地调用父类的构造方法,编译器会帮我们自动加一句super()

子类不会继承任何父类的构造方法。子类默认的构造方法是编译器自动生成的,不是继承的

sealed 用于限制一个类或接口允许哪些类型继承或实现。

1
2
3
public sealed class Shape
permits Circle, Rectangle {
}

表示 Shape 只允许 Circle 和 Rectangle 继承。

直接继承 Shape 的子类必须声明为以下三种之一:

  • final:不能再被继承
  • sealed:继续限制它的子类
  • non-sealed:解除限制,允许任意类继承

向下转型,向上转型

1
2
Student s = new Student();
Person p = new Student();

向上转型必须是子类继承父类

1
2
3
4
Person p1 = new Student(); // upcasting, ok
Person p2 = new Person();
Student s1 = (Student) p1; // ok
Student s2 = (Student) p2; // runtime error!

强制向下转型必须保证本来就是子类类型,加instanceof可以避免转换出错

判断instanceof后,可以直接避免再次强制转型。例如,对于以下代码:

1
2
3
4
5
Object obj = "hello";
if (obj instanceof String) {
String s = (String) obj;
System.out.println(s.toUpperCase());
}
1
2
3
4
5
Object obj = "hello";
if (obj instanceof String s) {
// 可以直接使用变量s:
System.out.println(s.toUpperCase());
}

组合 has

1
2
3
4
class Student extends Person {
protected Book book;
protected int score;
}

对于多态

编译时看左边,运行时看右边

1
2
3
4
5
6
Animal a = new Dog();
^^^^^^ ^^^^^^^^^
左边 右边

编译时类型 实际对象类型
Animal Dog
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Animal {
void eat() {
System.out.println("Animal eat");
}
}

class Dog extends Animal {
@Override
void eat() {
System.out.println("Dog eat");
}

void bark() {
System.out.println("汪汪");
}
}
1
2
3
4
Animal a = new Dog();

a.eat(); // 可以
a.bark(); // ❌ 编译错误
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
【编译阶段】                            
看左边 Animal
↓
Animal 有 eat() 吗?
↓
有
↓
编译通过


【运行阶段】
看实际对象 new Dog()
↓
Dog 重写 eat() 了吗?
↓
有
↓
执行 Dog.eat()

抽象类,接口类

在Java中,一个类只能继承自另一个类,不能从多个类继承。但是,一个类可以实现多个interface

default

假设原来有一个接口:

1
2
3
interface Person {
String getName();
}

并且已经有很多实现类:

1
2
3
class Student implements Person { }
class Teacher implements Person { }
class Worker implements Person { }

如果直接新增一个抽象方法:

1
2
3
4
interface Person {
String getName();
void run();
}

所有实现类都必须立即实现 run(),否则无法编译。

如果新增为默认方法:

1
2
3
4
5
6
7
interface Person {
String getName();

default void run() {
System.out.println(getName() + " run");
}
}

原来的实现类不需要修改就能继续使用;只有需要特殊行为的类才重写 run()。

default方法和抽象类的普通方法是有所不同的。因为interface没有字段,default方法无法访问字段,而抽象类的普通方法可以访问实例字段。

关于包

包没有父子关系。java.util和java.util.zip是不同的包,两者没有任何继承关系。

匿名类

  • 没有类名的类,定义类的同时立刻创建对象。
  • 语法:
1
2
3
new 父类或接口() {
// 类体
}
  • 可以:
    • 实现接口
    • 继承一个类
    • 重写方法
    • 定义字段、方法、实例初始化块
  • 匿名类没有名字,所以不能像普通类一样单独重复 new。
  • 匿名类可以访问外部类成员,包括 private 成员。
  • 访问外部类同名成员时可用:
1
Outer.this.xxx
  • 例如:
1
2
3
4
5
6
Runnable r = new Runnable() {
@Override
public void run() {
System.out.println("hello");
}
};

模块

概念 全称 / 文件形式 是什么 主要作用 和其他概念的关系
module-info.java 模块描述文件 用来描述一个 Java 模块 使用 requires 声明依赖,使用 exports 开放包 它只是描述模块,不是模块本身
JAR .jar Java 最常见的打包格式 打包 .class、资源文件、第三方库、应用程序等 JAR 也可以包含 module-info.class,成为模块化 JAR
JRE Java Runtime Environment Java 程序的运行环境 提供 JVM 和运行 Java 程序需要的标准库 Java 程序最终运行在 JRE/JVM 提供的环境中
1
2
3
4
5
6
7
8
9
10
11
java.base.jmod        ← 一个 JMOD 文件
↓
java.base ← 一个模块
├── java.lang ← 包
│ ├── String
│ └── Object
├── java.util ← 包
│ ├── ArrayList
│ └── HashMap
└── java.io ← 包
└── File
1
2
3
4
5
6
7
Java 程序 / JAR
↓
JRE
↓
JVM
↓
操作系统

字符串类

结论:两个字符串比较,必须总是使用equals()方法。

trim()并没有改变字符串的内容,而是返回了一个新字符串。

另一个strip()方法也可以移除字符串首尾空白字符,类似中文的空格字符\u3000/也会被移除:

Java核心类

创建新对象时,优先选用静态工厂方法而不是new操作符。

1
2
3
4
5
BigDecimal 金额:
new BigDecimal("0.9") ✅
BigDecimal.valueOf(0.9) ✅

new BigDecimal(0.9) ❌ 尽量不要

instanceof

instanceof 是 Java 的保留关键字。它的作用是测试它左边的对象是否是它右边的类的实例,返回 boolean 的数据类型。

1
2
3
4
Number n = new Integer(...);
编译时类型 运行时类型
↓ ↓
Number Integer
1
Number n = Integer.valueOf(100);

这里有三件事要分开:

1
2
3
变量名:          n
变量的声明类型: Number
实际对象类型: Integer
1
2
3
4
n instanceof Integer   // true
n instanceof Number // true

n.getClass() // Integer.class

java bean

有很多class的定义都符合这样的规范:

  • 若干private实例字段;
  • 通过public方法来读写实例字段。

例如:

1
2
3
4
5
6
7
8
9
10
public class Person {
private String name;
private int age;

public String getName() { return this.name; }
public void setName(String name) { this.name = name; }

public int getAge() { return this.age; }
public void setAge(int age) { this.age = age; }
}

如果读写方法符合以下这种命名规范:

1
2
3
4
// 读方法:
public Type getXyz()
// 写方法:
public void setXyz(Type value)

那么这种class被称为JavaBean:

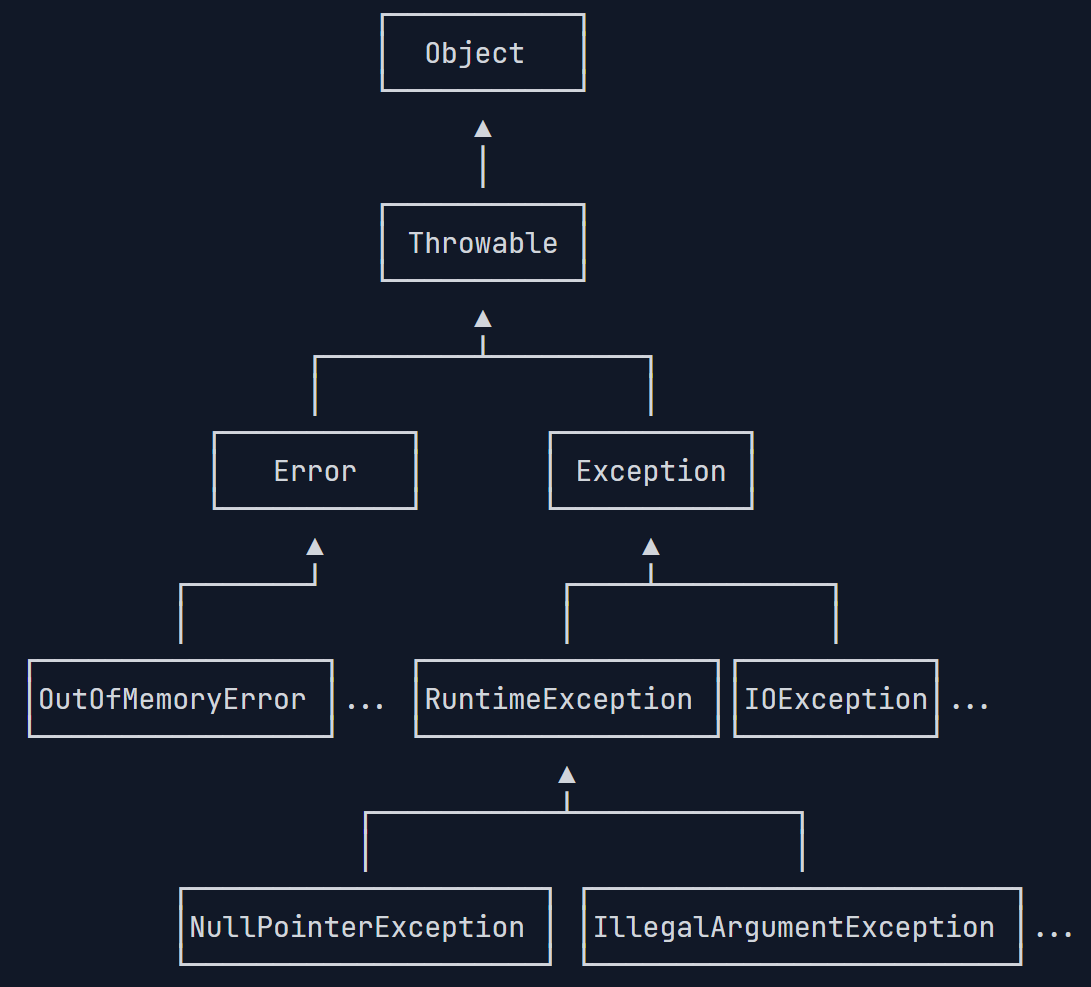
异常

  • Checked Exception 必须处理:要么 catch,要么 throws。
  • catch:我在这里处理异常。
  • throws:我不处理,交给调用我的方法处理。
  • throw:真正抛出一个异常对象。
  • 异常会沿着调用栈向上传递:
1
2
3
4
5
6
7
getBytes()
↓ 抛异常
toGBK()
↓ throws
main()
↓ catch
处理异常
关键字 作用 写在哪
throw 真正抛出一个异常对象 方法体里面
throws 声明这个方法可能抛异常 方法声明后面
1
2
3
4
5
void test(int age) throws Exception {
if (age < 0) {
throw new Exception("年龄不能小于0");
}
}

多个 catch:子类异常放前面,父类异常放后面;否则编译不过。

捕获异常后再次抛出时,尽量保留原始异常作为 cause。

1
2
3
catch (NullPointerException e) {
throw new IllegalArgumentException(e);
}
知识点 作用
throw new XxxException() 主动抛异常
异常传播 当前方法不捕获 → 向调用者传播
printStackTrace() 打印完整异常调用栈
new XxxException(e) 抛新异常并保存原异常
getCause() 获得原始异常
finally 即使 catch 再抛异常,一般仍执行
finally 抛异常 可能屏蔽原本异常,应避免
addSuppressed() 保存被屏蔽的异常
getSuppressed() 获取被屏蔽的异常

image-20260909162547999

1
2
3
4
5
6
catch 能不能捕获异常
不是看它们“都是 RuntimeException”

而是看:
抛出的异常是不是 catch 类型本身
或者 catch 类型的子类。

JDK Logging

  1. 用日志代替 System.out.println()

  2. 使用 java.util.logging.Logger

  3. 创建Logger:
    Logger.getGlobal()
    Logger.getLogger(ClassName.class.getName())

  4. 常用日志:
    logger.severe()
    logger.warning()
    logger.info()
    logger.fine()

  5. 日志级别:
    SEVERE
    WARNING
    INFO
    CONFIG
    FINE
    FINER
    FINEST

  6. 默认一般是INFO:
    INFO及以上显示
    FINE等较低级别默认不显示

  7. 日志可以:

    • 自动记录时间、类、方法
    • 设置级别
    • 输出到文件
    • 通过配置控制输出
  8. 异常处理中可以使用logger记录错误

Java第三方日志

  1. Commons Logging

    • 日志接口/门面
    • LogFactory创建Log
    • Log负责写日志
    1
    2
    3
    4
    5
    6
    7
    static final Log log =
    LogFactory.getLog(Main.class);

    log.info()
    log.warn()
    log.error()
    log.debug()

    异常:

    1
    log.error("发生异常", e);
  2. Log4j

    • 具体日志实现

    • 可作为Commons Logging背后的实现

    • 主要组件:
      Appender:输出位置
      Filter:过滤日志
      Layout:日志格式

    • log4j2.xml配置

    • 可以输出:
      Console
      File
      Socket
      JDBC

    • 支持日志文件滚动

  3. SLF4J

    • 日志接口/门面
    • 类似Commons Logging
    1
    2
    3
    4
    5
    6
    7
    static final Logger logger =
    LoggerFactory.getLogger(Main.class);

    logger.info()
    logger.warn()
    logger.error()
    logger.debug()
    • 支持{}占位符:

      1
      logger.info("user={}, age={}", user, age);
  4. Logback

    • 具体日志实现
    • 通常配合SLF4J
    • logback.xml进行配置
    • 可输出控制台、文件等

关系:

1
2
3
Commons Logging → Log4j

SLF4J → Logback

最重要思想:代码面向日志接口,具体日志实现通过依赖和配置决定。

1
2
3
4
5
6
7
       日志接口 / 门面
↓
Commons Logging SLF4J
↓ ↓
日志实现
↓
Log4j Logback

反射

通过Class实例获取class信息的方法称为反射(Reflection);

动态代理

动态代理主要用于在不修改原有业务类代码的情况下,在运行时为对象的方法统一增加额外功能,例如日志、事务、权限校验、性能统计等。它避免了为每个目标类手动编写代理类,同时实现了业务逻辑和通用功能的解耦。

软件工程复习笔记

第一章

软件工程的特性

⚫ 软件工程关注于大型程序的构造

⚫ 软件工程的中心课题是控制复杂性

⚫ 软件经常变化

⚫ 开发软件的效率非常重要

⚫ 和谐地合作是开发软件的关键

⚫ 软件必须有效地支持它的用户

⚫ 在软件工程领域中是由具有一种文化背景的人替具有另一种文化背景的人创造产品

基本原理

⚫用分阶段的生命周期计划严格管理

⚫坚持进行阶段评审

⚫实行严格的产品控制

⚫采用现代程序设计技术

⚫结果应能清楚地审查

⚫开发小组的人员应该少而精

⚫承认不断改进软件工程实践的必要性

三要素

软件工程三个要素:方法、工具、过程

软件过程的定义

为了获得高质量软件所需要完成的一系列任务框架,它规定了完成各项任务的工作步骤

四种模型

瀑布模型,每个阶段都经过仔细验证,应付需求变化能力较弱

快速原型模型,不带反馈环,开发快,过多修改容易带来版本管理的问题

增量模型,把软件分成一系列增量构件,当新构件集成到现有软件时,所形成的产品必须可测试。要求软件结构必须是开放的

螺旋模型,每个阶段都增加了风险分析,风险更小

喷泉模型,迭代重复演进,各阶段无明显界限。

第二章,可行性分析

题型:画数据流图,数据字典,成本效益分析

可行性研究的目的和内容

可行性研究的目的是用最小的代价,在尽可能短的时间内确定问题是否可以解决,以及是否值得解决

可行性:技术可行性,经济可行性,操作可行性

数据流图的概念(必考画图)

数据流图(DFD)是一种图形化技术,它描绘信息流和数据从输入移动到输出的过程中所经受的变换

数据流图大题讲解

数据字典的概念,和数据流图的关系,表示方法

软件工程速成之数据字典例题讲解

概念:数据的信息的集合,也就是对数据流图中所包含的所有元素的定义的集合通常采用半形式化方法表达。

数据字典与数据流图配合,能清楚地表达数据处理的要求

成本/效益分析

第三章,需求分析

相关题型:简答题,画ER图,画状态转换图,其余简答题

需求分析是生命周期模型中定义阶段的最后一个步骤的工作

结构化分析方法SA:分析系统数据流

SA的描述工具:

1.分层的数据流图

2.数据词典

3.描述加工逻辑的结构化语言,判定图或判定树

需求分析阶段任务

确定对系统的综合要求

功能需求,性能需求,可靠性和可用性需求,出错处理需求,接口需求,约束(精度;工具和语言约束;设计约束;应该使用的标准;应该使用的硬件平台。),逆向需求,未来可能的扩充要求

分析系统的数据要求

建立概念性的数据模型(ER图),形象描绘数据结构(层次方框图,Warnier图,IPO图),数据结构规范化

导出系统的逻辑模型

导出系统的逻辑模型(DFD+DD+IPO)

修正系统开发计划

修正系统开发计划(重估成本,进度)

与用户沟通获取需求的方法

访谈,面向数据流自顶向下求精(沿数据流图(DFD)回溯,用户复查, 细化数据流图(DFD)),简易的应用规格说明技术,快速建立软件原型

面向过程的分析方法主要是建立三类模型

模型核心:数据字典

数据模型:E-R图表达

功能模型:DFD表达

行为模型:状态转换图

需求分析的产品是什么

编制需求分析阶段的文档

⚫ 需求规格说明书,作为分析阶段最终成果,是需求分析阶段得出的最主要的文档

⚫ 数据要求说明书

⚫ 初步的用户手册

⚫ 修改、完善与确定软件开发实施计划

软件需求规格说明书的内容

通常用自然语言完整、准确、具体地描述系统的数据要求、功能需求、性能需求、可靠性和可用性要求、出错处理需求、接口需求、约束、逆向需求以及将来可能提出的要求。

常使用的图形工具

实体-联系图(和数据库里的一样)

状态转换图

通过描绘系统的状态及引起系统状态转换的事件,来表示系统的行为

软件工程数据流图,状态转换图速通教程

第五章,总体设计

题型:给数据流图画结构图

总体设计的任务

将系统划分成模块结构形式,决定每个模块要完成的功能,每个模块之间的调用关系,决定模块接口。

1.设想供选择的方案

2.选取合理的方案

⚫ 数据流程图

⚫ 组成系统的物理元素清单

⚫ 成本/效益分析

⚫ 进度计划

3.确定最佳方案

4.功能分解

5.设计软件结构(模块化思想)

6.数据库设计

7.制定测试计划

8.书写文档

⚫ 系统说明

⚫ 用户手册

⚫ 测试计划

⚫ 详细的实施计划

⚫ 数据库设计结果

9.审查和复查

模块化思想

自顶向下,逐步细化,抽象,逐步求精,信息隐藏和局部化,模块独立

模块化就是把程序划分成独立命名且可独立访问的模块,每个模块完成一个子功能,把这些模块集成起来构成一个整体,可以完成指定的功能满足用户的需求。

衡量模块独立的标准(内聚和耦合的含义,种类)(问答,选择)

耦合

是模块之间的互相连接的紧密程度的度量。

种类:(从低到高)非直接耦合,数据耦合,标记耦合,控制耦合,外部耦合,公共耦合,内容耦合

原则:尽可能使用数据耦合,少用控制耦合和特征耦合,限制公共环境耦合的范围,完全不用内容耦合

内聚

是模块强度(一个模块内部各个元素彼此结合的紧密程度)的度量。

种类:(按紧密程度从高到底排列)功能内聚,顺序内聚,通信内聚,过程内聚,时间内聚,逻辑内聚,巧合内聚。

模块独立性比较强的模块应是高内聚低耦合的模块。

启发式规则

1.改进软件结构提高模块独立性

2.模块规模适中

3.适当控制深度,宽度,扇出(一个模块直接调用控制的模块数),扇入(直接调用该模块的模块数,不破坏独立性的前提下,越大越好)

4.模块的作用域应该在控制域之内

5.降低模块接口的复杂程度

6.单出单入,避免内容耦合

7.设计功能可预测的模块,但要避免过分受限制的模块

掌握面向数据流图的设计方法

解决的任务,就是将软件需求分析阶段生成的逻辑模型数据流图映射(Mapping)成表达软件系统结构的软件结构图

image-20241129164607279

image-20241129164619780

第六章,详细设计

考简答,画NS图,PAD图,判定树,判定表,计算复杂度,jackson方法

详细设计的基本任务

结构程序设计,人机界面程序设计

程序的五种控制结构

五种控制结构:顺序结构,选择结构,先判断循环结构,后判断循环结构,多选择结构

详细设计的工具,之间的转换

图形工具:程序流程图、盒图(N-S图)、PAD图

NS图例题

表格工具:判定表、判定树

Jackson方法

McCabe方法计算复杂度

程序环形复杂性计算方法(三种):

(1)流图中区域的数量对应于环形复杂度

(2)给定流图G的环形复杂度V(G),定义为V(G)=E-N+2,E是流图中边的数量,N是流图中结点的数量。

(3)V(G)=P+1,P是流图G中的判定结点数。

第七章,实现

题型:设计测试样例

选择程序设计语言应该考虑哪些因素


一般情况下高级语言优于汇编语言

• 系统用户的要求

• 可以使用的编译程序

• 可以得到的软件工具

• 工程规模

• 程序员的知识

• 软件可移植性要求

• 软件的应用领域

良好的编程风格应该包括哪些方面


程序实际上也是一种供人阅读的文章,有一个文章的风格问题。应该使程序具有良好的风格

⚫ 源程序文档化(标识符、注解、视觉效果等)

⚫ 数据说明

⚫ 语句结构(简单、直接)

⚫ 输入/输出方法

⚫ 效率(程序运行时间、存储器效率、输入/输出效率)

软件测试的目的


目标:以尽可能小的代价,发现尽可能多的错误

尽可能多地发现并排除软件中潜藏的错误,最终把一个高质量的软件系统交给用户使用

初步 测试计划是在哪个阶段制定的


一旦完成了需求模型就可以着手制定测试计划,在建立了设计模型之后就可以立即开始设计详细的测试方案

黑盒测试和白盒测试的概念(问答题必考设计测试样例)


黑盒测试是把程序看成一个黑盒子,完全不考虑程序内部结构和处理过程的测试——功能测试

白盒测试是对程序的执行细节进行测试,通过设计测试数据,验证程序模块的每个路径的执行情况——结构测试

测试步骤(5个)以及与之相关的文档


软件测试的步骤

⚫ 模块测试(单元测试)——程序设计&代码bugs

⚫ 子系统测试——测试模块的接口

⚫ 系统测试——需求确认&系统设计

⚫ 验收测试——用户加入

⚫ 平行运行——新旧系统比较运行结果

单元测试的方法


代码审查,计算机测试

测试重点

1.模块接口测试

2.局部数据结构测试

3.路径测试

4.错误处理测试

5.边界测试

渐增式与非渐增式的区别


模块组装成系统的两种方式

非渐增式测试:

首先对每个模块分别进行模块测试,然后再把所有模块组装在一起进行测试,最终得到要求的软件系统

渐增式测试:

首先对一个个模块进行模块测试,然后将这些模块逐步组装成较大的系统。

在组装的过程中边连接边测试,以发现连接过程中产生的问题。通过渐增逐步组装成要求的软件系统。

分为自顶向下和自底向上两种方法

比较:

渐增式测试可以较早发现模块间的接口错误,非渐增式测试最后才组装,因此错误发现得晚。

非渐增式测试中发现错误后难以诊断定位,渐增式测试中,出现的错误往往跟最新加入的模块有关

渐增式测试在不断集成的过程中使模块不断在新的条件下受到新的检测,测试更彻底。

渐增式测试较非渐增式测试费时,非渐增式测试可以同时并行测试所有模块,能充分利用人力。

自顶向下,自下而上,以及混合策略的优缺点


1.自顶向下集成

优点:在早期即对主要控制及关键的抉择进行检验

问题:Stub只是对低层模块的模拟,测试时没有重要的数据自下往上流,许多重要的测试须推迟进行,而且在早期不能充分展开人力

2.自底向上集成(相反)

优点:模块自底向上组装,不需要桩模块,重要数据自下往上流动,可以提前完成重要测试,充分展开人力

缺点:不可以在早期就对主要控制进行检验

3.混合集成测试 兼具二者优点

改善的自顶向下测试,早期使用自底向上测试一些关键模块,其他一样

混合法:较下层采用自底向上,较上层采用自顶向下

确认测试


确认测试又称验收测试,任务是验证软件的功能和性能及其他特性是否与用户的要求一致。

对软件的功能和性能要求在软件需求规格说明。书中已经明确规定,它包含的信息就是软件确认测试的基础

确认测试应交付的文档有:

⚫ 确认测试分析报告⚫ 最终的用户手册和操作手册⚫ 项目开发总结报告

白盒测试技术(覆盖标准,基本路径)


每条路径对应表达式都写出来,表达式是给分关键

⚫语句覆盖(点覆盖):每个语句至少执行一次

⚫ 判定覆盖(边界覆盖):在语句覆盖的基础上,每个判定的每个分支至少执行一次

⚫ 条件覆盖:在语句覆盖的基础上,使每个判定表达式的每个条件都取到各种可能的结果

⚫ 判定/条件覆盖:即判定覆盖并条件覆盖

⚫ 条件组合覆盖:每个判定条件表达式中条件的各种可能组合都至少出现一次

⚫ 路径覆盖

黑盒测试技术(等级划分,边界值分析)

最好画个表

等价划分,错误推测

边界值分析,对等价类划分的补充

软件调试技术有哪些

蛮干法:强行排错

回溯法:一旦发现了错误,人们先分析错误征兆,确定最先发现“征兆”的位置

原因排除法:

1.归纳法

2.演绎法调试

3.对分查找法

软件可靠性(可靠性和可用性的含义)

可靠性(Reliability)

• 程序在给定的时间间隔内,按照说明书的规定,成
功地运行的概率

可用性(Usability)

• 程序在给定的时间点,按照说明书的规定,成功地
运行的概率

第八章,维护

什么是维护

软件维护就是在软件已经交付使用之后,为了改正错误或满足新的需要而修改软件的过程

维护的类型

⚫ 改正性维护(Corrective Maintenance)

⚫ 预防性维护(Preventive Maintenance)

⚫ 适应性维护(Adaptive Maintenance)

⚫ 完善性维护(Perfective Maintenance)

决定软件可维护性的因素

可理解性: 是指由文档代码理解功能运行的容易程度

可测试性:是指论证程序正确性的容易程度。

可修改性:是指程序容易修改的程度

可靠性

可移植性:表明程序转移到一个新的计算环境的可能性的大小

可使用性:定义为程序方便、实用、及易于使用的程度

效率:是指程序能执行预定义功能,而又不浪费机器
资源的程度

文档

⚫ 影响可维护性的决定因素,比代码更重要

⚫ 用户文档

• 功能描述——说明系统能做什么

• 安装文档——说明安装系统的方法及适应特定的硬件配置的方法

• 使用手册——说明使用方法以及错误挽救方法

• 参考手册——详尽描述用户可使用的所有系统设施以及他们的使用方法,给出错误信息注解表

• 操作员指南(如果需要有系统操作员的话)——说明操作员处理使用中出现的各种情况的方法

⚫ 系统文档

• 即软件生产过程中每一步产生的文档

维护是软件生命周期中所花费用最多的阶段

软件维护活动所花费的工作占整个生存期工作量的70%以上,维护成本约为开发成本的4倍(满足8-2原则)

第九~十二章 面向对象软件工程(考察较少)

几个概念:类,对象,继承,消息,属性,实例,多态性,重载

面向对象的方法(4个要素)

OOM=对象+类+继承+消息

对象(object):客观世界由对象组成。

⚫ 类 (class) :对象可划分为类;单个对象可视为某一类的实例 (instance)。

⚫ 继承(inheritance):类可分层,下层子类与上层父类有相同特征,称为继承。

⚫ 消息(message):对象间只能通过发送消息进行联系,外界不能处理对象的内部数据,只能通过消息请求它进行处理(如果它提供相应消息的话)。

面向对象方法的优点

① 与人类习惯的思维方式一致

②面向对象软件稳定性好

③ 面向对象软件可重用性好

④ 较易开发大型软件产品

⑤ 面向对象软件可维护性好

面向对象建模的三个模型,以及之间的关系

面向对象分析模型由3个独立模型组成:

⚫ 对象模型:最重要,开发任何系统都需要,

• 描述静态结构,定义做事情实体,用类图和对象图表示

⚫ 动态模型:对于开发交互式系统(interactive system)很重要

• 描述交互过程,由状态图和顺序图表示

⚫ 功能模型:对于开发大运算量问题(如科学计算、编译系统等)很重要

• 指明系统应“做什么”,由用例图表示

面向对象设计时要设计哪些子系统,及各个子系统的作用

问题域子系统,人机交互子系统,任务管理子系统,数据管理子系统

问题域:直接负责实现客户需求子系统

人机交互:实现用户界面子系统包括可复用的GUI子系统

任务管理:确定各类任务,把任务分配给适当的硬件或软件去执行

数据管理:负责对象的存储和检索的子系统

CMM等级划分(了解,选择题)

(1)初始级

(2)可重复级

(3)已定义级

(4)已管理级

(5)优化级

Dev-C++ 机试调试

适用场景:复试上机时使用 Dev-C++ 编写和调试 C/C++ 程序。
目标:把最常用的环境配置、调试流程、代码片段和提交前检查集中到这一份。

1. 先把环境配对

1.1 常用界面操作

  • Tools 下的环境设置可以切换界面语言。
  • Ctrl + 鼠标滚轮 可以放大或缩小编辑器字体。

1.2 编译与调试选项

进入 Tools > Compiler Options,重点确认这几项:

  • 编译参数建议包含:
1
-g -O0 -std=c++11 -Wall -Wextra -DLOCAL
  • 关闭优化:调试阶段优先用 -O0。
  • 打开调试信息:在代码生成或链接相关选项里,把 Generate debugging information / 产生调试信息 设为 Yes。
  • 修改编译选项后,执行一次 Rebuild All,不要只点普通编译。

说明:

  • -g:让断点、单步、变量查看生效。
  • -O0:避免优化导致行号乱跳、变量被优化掉。
  • -DLOCAL:方便在本地打开调试输出,提交前再关闭。

2. 上机时最实用的操作顺序

  1. 先把题目输入格式确认清楚,写最小可运行版本。
  2. 编译一次,先排掉语法错误和头文件问题。
  3. 用最小样例跑通,再测边界样例。
  4. 如果结果不对,优先用“断点 + Watch + 少量输出”定位。
  5. 如果程序崩溃,先查数组越界、空指针、循环边界。
  6. 提交前关闭调试开关,重新编译,再跑一遍样例。

3. Dev-C++ 里怎么调试最有效

3.1 断点打在哪里

  • 循环问题:打在循环入口、循环体第一行、下标更新前。
  • 分支问题:打在 if / else if 判断前。
  • 指针问题:打在 *p、a[i]、node->next 这类访问前。
  • 函数问题:打在调用前和函数入口处。

不要一开始满屏断点。先用 2 到 4 个关键断点缩小范围。

3.2 单步执行怎么选

  • Step Over:执行当前行,不进入函数内部。默认优先用它。
  • Step Into:进入函数内部。怀疑子函数有问题时再用。
  • Step Out:从当前函数退回调用处。进太深时很有用。
  • Continue:继续运行到下一个断点。

3.3 Watch 盯哪些变量

优先盯这些:

  • 循环变量:i、j、k
  • 边界变量:n、m、len
  • 结果变量:ans、sum、cnt
  • 指针或节点:p、head、tail
  • 当前读入值:x、y、ch

建议一次只加 3 到 5 个最关键变量,避免界面太乱。

3.4 调试输出什么时候更快

当循环很多、断点停太频繁时,直接加少量输出更快:

1
cerr << "DEBUG i=" << i << " a[i]=" << a[i] << " sum=" << sum << '\n';

建议统一加 DEBUG 前缀,提交前一起删掉或通过宏关闭。

4. 常见问题排查顺序

4.1 数组越界

  • 检查下标是否可能 < 0 或 >= n
  • 重点盯 i、j、n
  • 在 a[i] 访问前打断点

4.2 死循环

  • 看循环变量是否真的在变化
  • 看退出条件是否有机会满足
  • 打印每轮的 i/j/cnt/sum

4.3 指针异常

  • 解引用前先判断是否为 nullptr
  • 检查是否访问了失效对象
  • 链表重点看 next,树结构重点看左右孩子

4.4 输入输出异常

  • 检查读入格式是否和题目一致
  • 不要混用 cin/cout 和 scanf/printf
  • 对关键读入值做短输出确认

4.5 断点失效

  • 通常是没开 -g
  • 或者改完编译选项后没 Rebuild All
  • 或者优化没有关掉

5. 机试时可直接复制的代码片段

5.1 快速输入输出

1
2
3
ios::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);

5.2 本地调试开关

1
2
3
4
5
6
7
#ifdef LOCAL
#define DBG(x) cerr << #x << " = " << (x) << '\n'
#define LOG(msg) cerr << msg << '\n'
#else
#define DBG(x)
#define LOG(msg)
#endif

5.3 打印 vector

1
2
3
4
5
6
7
8
9
10
11
#ifdef LOCAL
template <class T>
void print_vec(const vector<T>& v) {
cerr << "[";
for (size_t i = 0; i < v.size(); ++i) {
if (i) cerr << ", ";
cerr << v[i];
}
cerr << "]\n";
}
#endif

经典基础

经典基础

一、核心易错点

1. 数组与越界

  • 循环变量和分类下标分离:不要用外层 i 直接访问固定小数组。
  • 容器访问前先判空或判长度:
1
2
if (!v.empty()) use(v[0]);
if (v.size() > 1) use(v[1]);

2. 输入输出

  • cin >> n 后接 getline,必须先吃掉换行符:
1
2
cin >> n;
cin.ignore();
  • 大数据 I/O 优化:
1
2
ios::sync_with_stdio(0);
cin.tie(0);
  • 固定宽度补零:printf("%05d\n", num)。
  • 输出优先 \n,避免频繁 endl。

3. 数据结构选择

  • 键可能重复时,不用 map 存主体数据(会覆盖),用 struct + vector + sort。
  • 不要求有序时优先 unordered_map/unordered_set。
  • 小范围计数(如 26 字母)优先数组。

4. 边界条件

  • 重点检查:0、空输入、区间端点、整除(余数为 0)。
  • 转换类题目做“正向 + 逆向”自检。

5. 算法策略

  • 能数组模拟就别硬改指针(如链表题可先按地址收集再处理)。
  • 位数少可枚举,位数大用 DFS + 剪枝。

二、字符串输入与分词

1. 按空白读取到 EOF

1
2
3
4
string word;
while (cin >> word) {
words.push_back(word);
}

2. 读取整行后按空格切词

1
2
3
4
5
6
7
string line;
getline(cin, line);
istringstream iss(line);
string word;
while (iss >> word) {
words.push_back(word);
}

3. cin >> n 与 getline 混用模板

输入流缓冲区陷阱:

先 cin >> 读数字,后用 getline() 读字符串,cin 残留的回车符会直接被 getline 吞掉导致读到空串。必须在两者之间加 cin.ignore(); 清理。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
int n;
cin >> n;
cin.ignore();

for (int i = 0; i < n; i++) {
string line;
if (!getline(cin, line)) break;
istringstream iss(line);
string word;
while (iss >> word) {
cout << word << ' ';
}
cout << '\n';
}

三、排序与比较器

1. sort + Lambda

1
2
3
sort(a.begin(), a.end(), [](const Node& x, const Node& y) {
return x.key < y.key;
});

2. 结构体内重载 <

1
2
3
4
5
6
7
8
9
10
struct Student {
int num, de, cai;
bool operator<(const Student& b) const {
if (de + cai == b.de + b.cai) {
if (de == b.de) return num < b.num;
return de > b.de;
}
return de + cai > b.de + b.cai;
}
};
  • 成员版 operator< 只写一个参数(右操作数)。
  • 建议加 const,保证比较不改对象。

四、map<int, bool> 常用写法

1. 插入/修改

1
2
3
mp[10] = true;
mp.insert({30, true});
mp.emplace(50, false);

2. 遍历(推荐写法)

1
2
3
for (const auto& [key, val] : mp) {
cout << key << ' ' << boolalpha << val << '\n';
}

五、区间与迭代器

1. begin() 与 end()

  • begin() 指向第一个元素。
  • end() 指向末尾后一个位置,不可解引用。

2. reverse 左闭右开

  • reverse(first, last) 作用区间是 $[first, last)$。
  • 示例:
1
2
reverse(v.begin(), v.begin() + 3); // 前 3 个
reverse(v.begin() + 1, v.end()); // 从第 2 个到末尾

六、格式化输出

1
cout << fixed << setprecision(n) << x << '\n';
  • fixed:固定小数格式。
  • setprecision(n):配合 fixed 时表示小数位数。

七、sort() 越界保护

1. 推荐:min 限制右边界

1
2
int end_idx = min(i + step, (int)a.size());
sort(a.begin() + i, a.begin() + end_idx);

2. 与 end() 比较

1
2
auto it_end = (a.begin() + i + step > a.end()) ? a.end() : a.begin() + i + step;
sort(a.begin() + i, it_end);

八、工程化小习惯

  • 比较前先判长度,不等直接返回。
  • vector 返回值可直接 return {a, b};。
  • 累加场景优先检查是否误写 =(应为 +=)。

这是一个为你整理的 C++ STL 关联容器与哈希表核心用法总结表。在刷题和面试时,你可以直接在脑海中调出这张表格,快速决定使用哪种数据结构。

九、C++ STL 核心容器对比与速查表

操作大类 具体方法 / 代码片段 适用容器 时间复杂度 (哈希表 / 红黑树) 核心说明与避坑指南
插入 / 修改 insert(val) 全部适用 $O(1)$ / $O(\log n)$ 插入元素。如果 Key 已经存在,则不会覆盖,插入失败。
emplace(args...) 全部适用 $O(1)$ / $O(\log n)$ 原地构造元素,省去拷贝/移动开销,性能通常优于 insert。
container[key] = val 仅 map, unordered_map $O(1)$ / $O(\log n)$ 最常用。Key 存在则修改 Value;Key 不存在则创建并赋默认值。
查找 / 访问 find(key) 全部适用 $O(1)$ / $O(\log n)$ 查找 Key。找到返回对应迭代器,没找到返回 container.end()。
count(key) 全部适用 $O(1)$ / $O(\log n)$ 返回 Key 的数量。在不允许重复的容器中,只能返回 1 或 0(常用于判断存在性)。
at(key) 仅 map, unordered_map $O(1)$ / $O(\log n)$ 访问对应 Key 的 Value。如果 Key 不存在,会抛出越界异常,比 [] 更安全。
lower_bound(key) 仅 set, map (有序) $O(\log n)$ 返回指向第一个 大于或等于 key 的迭代器。哈希表不支持。
upper_bound(key) 仅 set, map (有序) $O(\log n)$ 返回指向第一个 严格大于 key 的迭代器。哈希表不支持。
删除 erase(key) 全部适用 $O(1)$ / $O(\log n)$ 直接根据 Key 删除元素。返回被删除元素的个数(0 或 1)。
erase(iterator) 全部适用 摊还 $O(1)$ 删除迭代器指向的元素(常用于遍历时按条件删除)。
clear() 全部适用 $O(n)$ 清空容器中的所有元素。
容量 / 状态 empty() 全部适用 $O(1)$ 检查容器是否为空。返回 true 或 false。
size() 全部适用 $O(1)$ 返回当前容器中元素的个数。

核心操作速记 (适用于以上所有 STL 容器)

  • 查找是否存在: 首选:if (container.find(key) != container.end())
    • 次选(仅限 set/map):if (container.count(key) > 0)
  • 插入元素:
    • set / unordered_set: insert(key)
    • map / unordered_map: container[key] = value (最方便) 或 insert({key, value})
  • 删除元素:
    • 按值删除:erase(key)
  • 遍历容器:
    • C++11 写法:for (auto it : container)
    • C++17 结构化绑定 (针对 map):for (auto [key, value] : my_map)

十、算法题型强化(从 N 数之和开始)

这一部分按“题型框架 -> 高频坑点 -> 可复用模板思维”整理,便于刷题时快速调用。

1. N 数之和家族(3Sum / 4Sum)

题型总框架

  • 先排序,再做枚举 + 双指针。
  • 去重必须发生在遍历过程中,而不是预处理阶段。
  • 4Sum 及以上场景优先考虑剪枝,否则容易超时。

四个高频坑点

  1. 不能提前去重
  • 不要先用 set 对原数组去重。
  • 原数组中的重复值可能是合法答案的一部分,例如 [0, 0, 0]。
  1. 去重边界要写准
  • 外层去重:if (k > 0 && nums[k] == nums[k - 1]) continue;
  • 内层去重:if (i > k + 1 && nums[i] == nums[i - 1]) continue;
  • 关键点:内层必须和当前层起点比较,不能写成 i > 0。
  1. 警惕整型溢出
  • 多个 int 累加时可能溢出。
  • 计算和时先提升类型:(long long)nums[k] + nums[i] + ...。
  1. 剪枝时分清 break 与 continue
  • 最小和已经大于 target:后续只会更大,直接 break。
  • 最大和仍小于 target:当前值太小,应该 continue。

2. 回溯算法(Backtracking)

统一骨架

终止条件 -> 做选择 -> 递归 -> 撤销选择。

两种写法对比

  1. 值传递写法(易写易懂)
  • 形式:void backtrack(int n, string path)
  • 递归:backtrack(n, path + ch)
  • 特点:天然不需要手动撤销,代码直观。
  • 代价:频繁拷贝字符串,适合 $n$ 很小(如 $n \le 10$)。
  1. 引用传递写法(面试主流)
  • 形式:void backtrack(int n, string& path)
  • 必须严格遵循:加入字符 -> 递归 -> pop_back()。
  • 特点:性能更好,适合规模更大的搜索。

3. 哈希表优化思路

思路一:分组哈希(降维)

  • 典型题:四数相加 II(四个独立数组)。
  • 做法:前两数组求和计数,后两数组查补数 0 - c - d。
  • 复杂度从 $O(n^4)$ 降为 $O(n^2)$。

思路二:能用定长数组就别用哈希

  • 当键空间很小且固定(如 26 个小写字母)时,优先 int hash[26] = {0};。
  • 数组访问常数更小、内存连续、实现也更稳定。

4. 一页速记(实战决策)

  • N 数之和:排序 + 双指针 + 分层去重 + 剪枝。
  • 回溯:小规模可值传递,大规模用引用传递并手动撤销。
  • 哈希优化:先看能否分组降维,再看能否降到定长数组。

十一、二叉树与 C++ 核心机制

1. 二叉树的遍历框架(基础必须如肌肉记忆般熟练)

1. DFS 迭代法(前、中、后序)

  • 核心数据结构:栈 (stack)。注意栈是后进先出 (LIFO)。
  • 易错点:写前序遍历时,压栈顺序必须是先压右孩子,再压左孩子,这样出栈时才是“先左后右”。

2. BFS 层序遍历

  • 核心数据结构:队列 (queue)。
  • 黄金模板:每次 while 循环开头,一定要先定格 int size = q.size();,然后用 for(int i=0; i<size; i++) 处理当前层,千万别和刚加进来的下一层节点混淆。

2. 树的属性与形态判定(思维陷阱高发区)

1. 最小深度 (Min Depth) 的“单身狗”陷阱

  • 教训:遇到空节点不能直接算作叶子返回 0。如果一个节点只有左孩子没有右孩子,你必须顺着左边往下走,不能抄右边的空指针近道。

2. 对称二叉树 (Symmetric Tree)

  • 教训:队列不支持下标访问(q[i] 报错)。正确的迭代法是成对入队,每次弹出两个节点对比,然后按 [左的左, 右的右] 和 [左的右, 右的左] 的顺序压入。

3. 平衡二叉树 (Balanced Tree) 的 $O(N)$ 优化

  • 教训:自顶向下的递归会导致 $O(N^2)$ 的重复计算。
  • 神仙操作:利用自底向上,在求深度的同时判断高度差。一旦发现不平衡,直接返回 -1 作为报错信号,一路剪枝到顶。

4. 左叶子之和 (Sum of Left Leaves)

  • 教训:当前节点无法判断自己是不是“左叶子”。必须站在父节点去判断:root->left && !root->left->left && !root->left->right。

3. 高阶算法思想的应用

1. 完全二叉树的节点数(二分搜索思想)

  • 核心公式:满二叉树节点数 = (1 << height) - 1 (注意防溢出,必要时用 1LL)。
  • 神级优化:一直向左走测出左右子树的高度。如果 leftH == rightH,说明左子树是满的;如果 leftH > rightH,说明右子树是满的。每次直接抛弃一半,复杂度降为 $O(\log^2 N)$。

2. 回溯算法初步(Binary Tree Paths & Path Sum)

  • 传值 vs 传引用:传 string path (传值) 会自动拷贝,不需要你手动清理;传 vector<int>& path (传引用) 必须成对出现 push_back 和 pop_back(做选择与撤销选择)。
  • 做减法:路径总和问题,最好带着 targetSum - root->val 往下传,到叶子节点看是否刚好归零。

4. 二叉树的重构(纯靠索引操作)

1. 从中序与后序遍历构造二叉树

  • 教训 1:建好的子树一定要挂载到父节点上(node->left = ...)。
  • 教训 2:切分数组时,不要用绝对下标相加!唯一可靠的指标是算出一个 leftSize(左子树长度)。
  • 切分公式:leftSize = index - inBegin。然后顺着后序数组的开头数 leftSize 个人,硬切开左右子树。

5. C++ 语言与语法避坑指南

1. 变量遮蔽 (Variable Shadowing)

  • 惨痛教训:在 while 循环外定义了 TreeNode* cur,如果在循环里又写了 TreeNode* cur = q.front(),外部的 cur 就废了!更新外部变量时千万别加类型。

2. STL 队列操作

  • C++ 的 q.pop() 返回值是 void!必须先 q.front() 拿到值,再去 q.pop() 弹出。

3. 防呆设计 (Null Pointer Check)

  • 任何递归或循环的第一步,永远是 if (!root) return ...;,直接拦截空指针,防止 Segfault。

十三、转义字符

反斜杠必须转义:

题目要求的错误提示包含 \,在 C++ 字符串中必须写成双反斜杠 **\\**,即 cout << "Are you kidding me? @\\/@";。

死循环与段错误:

找右括号 ] 时,循环条件必须加上 j < line.size() 保护。如果输入数据残缺(只有 [ 没有 ]),不加保护直接内存越界。

十四、整除

在中文语境和数学严谨表达中,“A 可以整除 B” 的含义是:B 是被除数,A 是除数。

  • A 整除 B(记作 $A | B$):意味着 $B \div A$ 的结果是一个整数。
  • A 被 B 整除:意味着 $A \div B$ 的结果是一个整数。

所以,题目中“正整数 N 可以整除它的 4 个不同正因数之和”对应的数学表达式是:

$$\frac{\text{因数1} + \text{因数2} + \text{因数3} + \text{因数4}}{N} = \text{整数}$$

也就是说,这 4 个因数的“和”,必须是 $N$ 的倍数。

十五、螺旋矩阵

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
void solve() {
int N;
cin >> N;
vector<int> vec(N);
for (int i = 0; i < N; i++) {
cin >> vec[i];
}

// TODO 1: 对 vec 进行降序排序
sort(vec.begin(),vec.end(),[](int a,int b){
return a > b;
});
int m = 0, n = 0;
// TODO 2: 计算行数 m 和列数 n
// 提示: 令 n = sqrt(N),循环递减 n 直到 N % n == 0,求出 m
for(n = sqrt(N);n >= 1;n--){
if(N % n == 0){
m = N / n;
break;
}
}
// cout << m << " " << n << endl;
// 初始化二维矩阵 (注意一定要等 m 和 n 算出来后再初始化)
vector<vector<int>> matrix(m, vector<int>(n));

// 定义四个边界
int top = 0, bottom = m - 1;
int left = 0, right = n - 1;
int index = 0; // 记录当前填到了 vec 中的第几个数

// TODO 3: 螺旋填充核心逻辑
while (index < N) {
// 1. 从左到右填充上边界,填完后上边界下移
// 提示: for (int j = left; j <= right && index < N; j++) ...
//00 -> 0n
for(int j = left; j <= right && index < N;j++){
matrix[top][j] = vec[index++];
}
top ++;
// 2. 从上到下填充右边界,填完后右边界左移
//1n -> mn
for(int j = top;j <= bottom && index < N;j++){
matrix[j][right] = vec[index++];
}
right--;
// 3. 从右到左填充下边界,填完后下边界上移
//mn -> m0
for(int j = right;j >= left && index < N;j--){
matrix[bottom][j] = vec[index++];
}
bottom--;
// 4. 从下到上填充左边界,填完后左边界右移
//m0 -> 10
for(int j = bottom;j >= top && index < N;j--){
matrix[j][left] = vec[index++];
}
left++;
}

}

os复习

操作系统

填空题(1*20=20分)简单看看概念

选择题(1*20+ 2 * 5=30分)

简答题(4*5=20分)5道题目,辅修考了:进程的概念,基本特征,中断处理过程

综合题(5*6=30分)6道题目,

考:银行家算法,作业调度算法,PV原语,管程,页面替换算法,存储空间管理,文件索引

[TOC]

绪论

操作系统的定义

操作系统是计算机系统中的一个系统软件,是一些程序模块的集合,它们管理和控制计算机系统中的硬件及软件资源,合理地组织计算机工作流程。以便有效地利用这些资源为用户提供一个具有最够的功能、使用方便、可扩展、安全和可管理的工作环境,从而在计算机与用户之间起到接口的作用。

操作系统的基本类型和特点

批处理操作系统

操作员把用户提交的作业分类,把一批作业编成一个作业执行序列,由专门编制的监督程序自动依次处理

特点:用户脱机使用计算机、成批处理、多道程序运行

分时操作系统

把处理机的运行时间分成很短的时间片,按时间片轮转的方式,把处理机分配给各个进程使用

特点:交互性、多用户同时性、独立性

实时操作系统

在被控对象允许时间范围内做出响应

特征:对实时信息分析处理速度要比进入系统快、要求安全可靠

微机操作系统

单用户单任务OS

只允许一个用户上机,且只允许用户程序作为一个任务运行

最具代表性的是CP/M和MS-DOS

单用户多任务OS

只允许一个用户上机,但允许将一个用户程序分为若干个任务,使他们并发执行

最具代表性的是os/2和MS-WINDOWS

多用户多任务OS

允许多个用户通过各自的终端使用同一台主机,共享主机的各类资源,同时用户程序又可以分成几个任务使它们并发执行

最具代表性的是UNIX OS

操作系统的功能

处理机管理

存储管理

设备管理

文件系统管理(信息管理)

用户接口

程序一级接口

作业一级接口

思考题

问题:鼠标点击“绪论.ppt”图标到屏幕上显示该文件内容

这个过程中,按照先后顺序描述操作系统完成了哪些功能?(尽可能描述细节)

鼠标点击—设备管理,用户接口

启动powerpoint程序—-存储管理,处理器管理

打开绪论.ppt文件—-文件管理,设备管理,存储管理

在屏幕上显示—-设备管理,用户接口

操作系统的特点

并发是两或多个事件在同一时间间隔内发生。

共享性:系统中的所有资源不再为一个程序所独占,而是供同时存在于系统中的多道程序所共同使用

虚拟是指通过某种技术把一个物理实体变为若干个逻辑上的对应物

异步性和不确定性:程序的执行并非“一气呵成”,而是以“走走停停”的方式运行,即程序是以异步方式运行的

作业

是指在一次应用业务处理过程中,从输入开始到输出结束,用户要求计算机所做的有关该次业务处理的全部工作

系统调用

作用:系统调用是系统向编程人员(应用程序,用户程序)提供的唯一接口

实现过程:

(1)用户在源程序中使用系统调用,并给出系统调用名和参数,即产生一条相应的陷阱指令

(2)处理机在执行到这条指令后,引起处理机中断,并发出有关信号给陷阱处理机构

(3)该处理机构收到信号后,启动相关程序保护处理机现场,取系统调用功能号并寻找子程序入口,通过入口地址表找到该系统子程序并执行

(4)执行完毕后,退出中断,返回到用户程序的断点,恢复现场,继续执行用户程序

进程管理

程序顺序执行的特征

顺序性,一个程序开始执行必须要等到前一个程序已执行完成。

封闭性,程序一旦开始执行,其计算结果不受外界因素影响。

可再现性,程序的结果与它的执行速度无关(即与时间无关),只要给定相同的输入,一定会得到相同的结果

程序并发执行的特征

间断性,“走走停停”,一个程序可能走到中途停下来,失去原有的时序关系

失去封闭性,程序在并发执行时,是多个程序共享系统中的各种资源,因而这些资源的状态将由多个程序来改变,致使程序的运行失去了封闭性

不可再现性,程序在并发执行时,由于失去了封闭性,也导致失去了可再现性

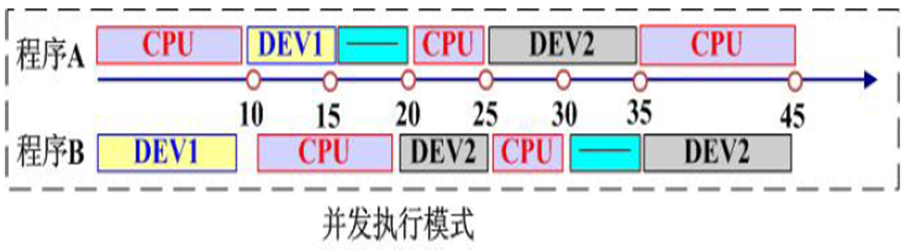
并发

概念,一组在逻辑上相互独立的程序或程序段在执行过程中,其执行时间在客观上相互重叠

并发带来的效率提升
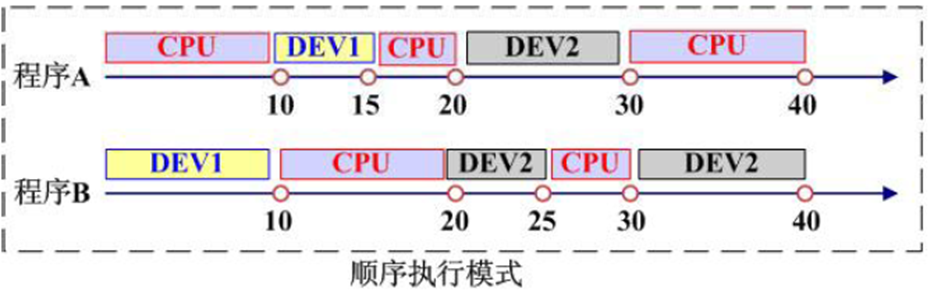
image-20241211161920342 image-20241211161935929

进程

概念:在操作系统中进程是一个拥有资源的基本单位,也是一个调度和执行的基本单位

特征:动态性(最基本),并发性,独立性,异步性,结构特性

区别 联系
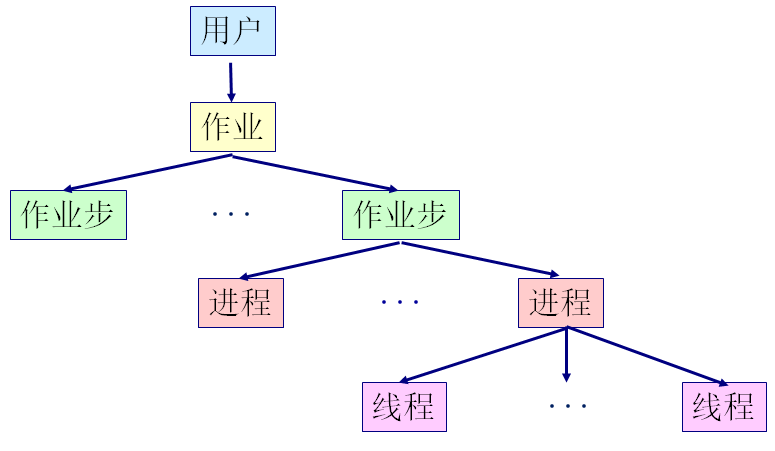
作业 用户向计算机提交任务的任务实体 一个作业可由多个进程组成,且必须至少一个
进程 1.完成用户任务的执行实体,具有并发特性。2.进程是竞争计算机系统资源的基本单位,从而其并发性受到系统自己的制约。
程序 静态概念,没有并发特性 不同的进程可以包含同一程序,只要该程序所对应的数据集不同。
image-20241211164506642

进程的静态结构

PCB :OS感知进程的存在的唯一标识

PCB,由进程创建原语创建

程序段

数据结构集

进程状态转换

执行,等待,就绪
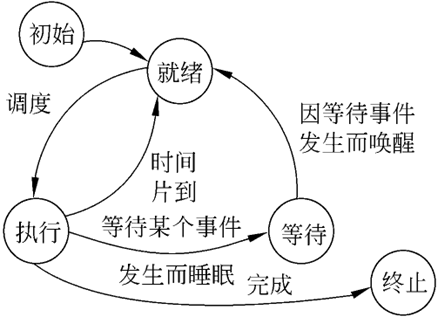
image-20241211200805596

思考题

如果系统中有N个进程,运行的进程最多几个,最少几个;就绪进程最多几个,最少几个;等待进程最多几个,最少几个?

答:最多有1个进程运行,最少是0个,就绪进程最多N-1个,最少0个

等待进程最多N个,最少0个(死锁)

原语

概念:是指系统态下执行的某些具有特定功能的程序段

原语又称为“原子操作(Atomic Operation)”过程,作为一个整体而不可分割——要么全都完成,要么全都不做

机器指令级的:执行期间不允许中断

功能级的:作为原语的程序段不允许并发执行

临界区

概念:一个进程访问临界资源的那段程序代码称为临界部分或者称为临界区.即访问公用数据的那段程序

使用准则:

(1)不能假设各并发进程的相对执行速度。即各并发进程享有平等的、独立的竞争共有资源的权利,且在不采取任何措施的条件下,在临界区内任一指令结束时,其他并发进程可以进入临界区

(2)并发进程中的某个进程不在临界区时,它不阻止其他进程进入临界区;放弃处理机

(3)并发进程中的若干个进程申请进入临界区时,只能允许一个进程进入。

(4)从并发进程中的某个进程申请进入临界区时开始,应在有限时间内能够进入其临界区

即:空则让进,等则让权(让权等待),忙则等待,等则有限

信号量

信号量的本质是计数器,一个口袋,P是申请拿球,V是放球

sem>0表示有sem个资源可用

sem=0表示无资源可用

sem<0则| sem |表示sem等待队列中的进程个数

sem的应该初值大于等于零

P(S):表示申请一个资源

V(S):表示释放一个资源

进程互斥的实现

软件法:通过平等协商方式实现进程互斥

单标志算法,双标志、先检查算法,双标志、先修改后检查算法,先修改、后检查、后修改者等待算法

硬件法:关中断,专用指令(testset, swap)

信号量

单个临界资源:整型信号量,记录型信号量

多个临界资源:AND型信号量

管程

条件变量:cwait,csignal

局部变量,操作

实现进程的同步和互斥

进程的互斥:由于共享资源而引起的在临界区内不允许并发进程交叉执行的现象称为由共享公有资源而造成的对并发进程执行速度的间接制约

进程的同步:由于并发进程互相共享对方的私有资源所引起的直接制约

进程的前驱关系(时间同步)

一组有关的并发进程在执行时间上有严格的先后顺序时,就会出现时间上的进程同步问题,或者称为进程的前驱关系

进程通信

低级通信:进程之间控制信息的交换。一般只传送一个和几个字节的信息,达到控制进程执行速度的作用。(进程的同步和互斥)

高级通信:用户可以直接利用操作系统所提供的一组通信命令,高效地传送大量数据的一种通信方式。

方式:主从式 (master-servant system)  ,会话式(dialogue system),

消息或信箱机制(message),共享存储区方式(shared memory)

死锁

**概念:**指多个进程因竞争资源而造成的一种僵局,若无外力的作用,这些进程将永远不能再向前推进

产生死锁的必要条件:互斥,部分分配,不剥夺条件,环路等待

  1. Mutual-exclusion - 一个口袋一个球,得到球才能继续
  2. Wait-for - 得到球的人想要更多的球
  3. No-preemption - 不能抢别人的持有的球
  4. Circular-chain - 形成循环等待球的关系

预防死锁

**预防死锁设计思路:**设置某些限制条件,去破坏死锁四个必要条件中的一个或多个,来防止死锁。

防止“互斥条件”:使用Spooling技术来管理设备

防止“不剥夺”条件的出现:一个已经保持了某些资源的进程,当它再提出新的资源要求而不能立即得到满足时,必须释放它已经保持的所有资源,待以后需要时再重新申请

防止部分分配(摒弃请求和保持条件):系统要求任一进程必须预先申请它所需的全部资源,而且仅当该进程的全部资源要求能得到满足时,系统才能给予一次性分配,然后启动该进程运行

防止“环路等待”条件的出现:把系统中所有资源类型线性排队,并按递增规则赋予每类资源以唯一的编号,进程申请资源时,必须严格按资源编号的递增顺序进行,否则系统不予分配

死锁避免:

安全状态:存在某种资源调度顺序,来为每个进程分配其所需资源,直至最大需求,保证所有进程正常运行完成,则称该状态为安全状态。

不安全状态:不存在可满足所有进程正常运行的资源调度顺序,则称该状态为不安全状态

避免死锁的实质是如何使系统不进入不安全状态

银行家算法

判断是否为安全状态,对于进程的资源请求,判断是否能够进行分配

银行家算法_Banker’s_Algorithm_哔哩哔哩_bilibili

死锁的检测和恢复

死锁的检测:实质是确定是否存在环路等待现象

死锁的恢复:立即结束所有进程的执行,并重新启动操作系统;撤销进程;剥夺资源

线程

线程是调度和执行的基本单位,不作为独立分配资源的单位

引入线程则是为了减少程序并发执行时的所付出的时空开销

线程本身拥有少数资源,多个线程共享所属进程的资源

线程分类:用户级线程,系统级线程

适用范围:多处理机系统,网络与分布式系统

处理器调度

调度的分级

作业调度(宏观调度,高级调度),交换调度(中级调度),内外存的进程交换,进程调度,分配处理机

作业调度的衡量

周转时间:从提交到完成的时间

带权周转时间:周转时间除运行时间

调度算法(考)

先来先服务(FCFS):将用户作业和就绪进程按提交顺序或变为就绪状态的先后排成队列,并按照先来先服务的方式进行调度处理,它优先考虑在系统中等待时间最长的作业,而不管要求运行时间的长短

轮转法:

把CPU划分成若干时间片。将系统中所有的就绪进程按照FCFS原则,排成一个队列每次调度时将CPU分派给队首进程,让其执行一个时间片

时间片的选择:

时间片长度S=R/Nmax

R:响应时间;

Nmax:最大进程数

多级反馈轮转法:

系统中设置多个就绪队列

每个就绪队列分配给不同时间片,优先级高的为第一级队列,时间片最小,随着队列级别的降低,时间片加大

优先级法:静态优先级,动态优先级

最短作业优先法

对预计执行时间短的作业(进程)优先分派处理机

比FCFS改善平均周转时间和平均带权周转时间,缩短作业的等待时间;

提高系统的吞吐量

最高响应比优先法:响应比R = 1 +(作业等待时间/ 作业执行时间)

实时系统中的任务分类

按照时限严格程度类型分类

硬实时任务:要求系统必须完全满足任务的时间要求

软实时任务:允许系统对任务的时限要求有一定的延迟,时限要求是一个相对条件

按照时限是周期or时刻分类

周期性任务:要求在周期T内完成或开始进行处理

非周期性任务:存在一个完成或开始进行处理的时间

存储管理

概念

**逻辑地址:**程序经编译或汇编以后形成目标程序,其指令的顺序都是以零作为参考地址,这些地址称为 逻辑地址

虚拟地址空间:

虚存容量的扩大是以牺牲CPU工作时间以及内、外存交换时间为代价的 (时间换空间)

虚拟存储器的最大容量(用户编程空间)由计算机的地址结构和寻址方式决定

如直接寻址时,若CPU的有效长度为16位,则其地址范围是0~~64K-1(216-1),最大容量为64K**(确认地址位数)**

静态重定位

在装入一个作业时,把作业中的指令地址和数据地址全部转换为物理地址(地址转换工作是在作业执行前集中一次完成的)在作业执行过程中就无须再进行地址转换工作

动态重定位:地址转换是在作业执行时动态完成

内存保护

上下界保护法

在CPU中设置一对上界寄存器和下界寄存器存放用户作业在内存中的起始地址和终止地址;每当CPU要访问内存时,硬件自动将被访问的内存地址与界限寄存器的内容进行比较,以判断是否越界

保护键法

为每一个被保护存储块分配一个单独的保护键。保护键可设置成对读写同时保护的或只对读、写进行单项保护的;在程序状态字中则设置相应的保护键开关字段, 不同的进程赋予不同的开关代码;

界限寄存器与CPU的用户态或核心态工作方式相结合的保护方式

在这种保护模式下,用户态进程只能访问那些在界限寄存器所规定范围内的内存部分,而核心态进程则可以访问整个内存地址空间

内存扩充

覆盖方式:

一个程序的几个代码段或数据段,按照时间先后来占用公共的内存空间

交换方式:

由操作系统把那些在内存中处于等待状态的进程换出内存,以及把那些等待事件已经发生,处于就绪态的进程换入内存,以及那些即将执行的程序数据调入内存

调入方式:

请求调入方式, 预调入方式

内存管理

常用方法:

分区存储管理,页式管理,段式管理,段页式管理

动态分区分配

最先适应法:要求空闲分区按首址递增的次序组织可用表或自由链

最佳适应法:空闲分区链按照分区容量递增的方式形成

最坏适应法:要求空闲区按大小递减的顺序组织可用表(或自由链)

动态分区回收:
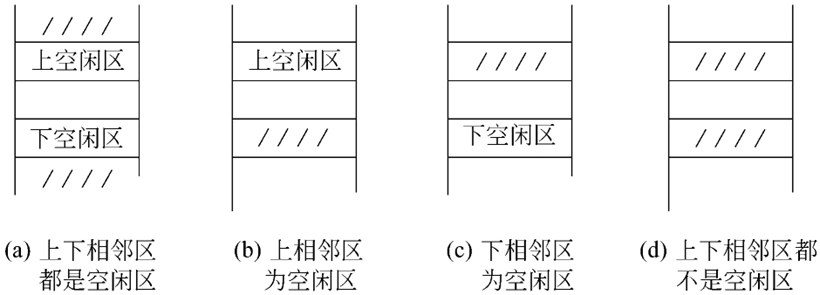
image-20241212112546853

a,与空闲区合并。b,与上空闲区合并。c,与下空闲区合并。d,不合并

缺点:

所谓“碎片”(fragmentation):就是指不能分配给作业使用的一段无效存贮空间。

固定分区管理存在内碎片,可变分区管理存在外碎片

碎片使得内存的空闲空间得不到充分利用,并且存储每个用户作业都要受到实际存储容量的限制。

页式管理(考计算)

页式管理中给定逻辑地址的组成,页表,将逻辑地址转换为物理地址

计算过程:程序地址/页长

页式管理的问题:CPU要存取一个数据,需访问主存两次

解决:快表
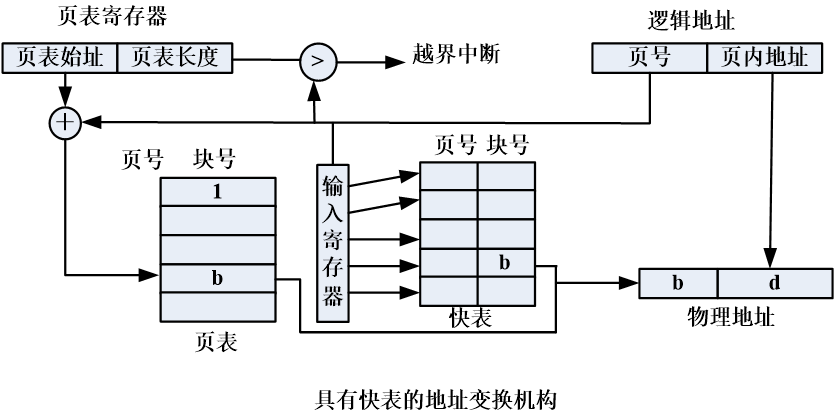
image-20241212113343060

请求(动态)页式管理的实现:

与每个虚页号相对应,除了页面号之外,再增设该页是否在内存的中断位以及该页在外存中的副本起始地址,还应增加一项以记录该页是否曾被改变
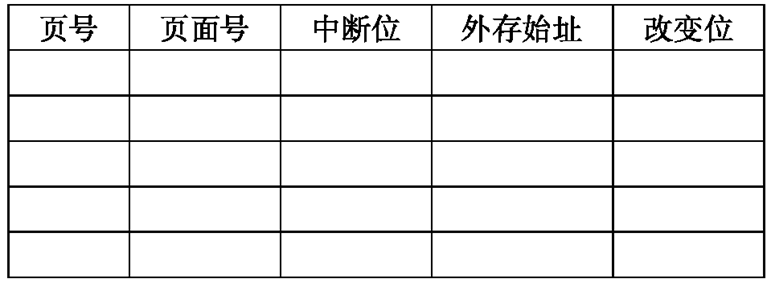
image-20241212113502613

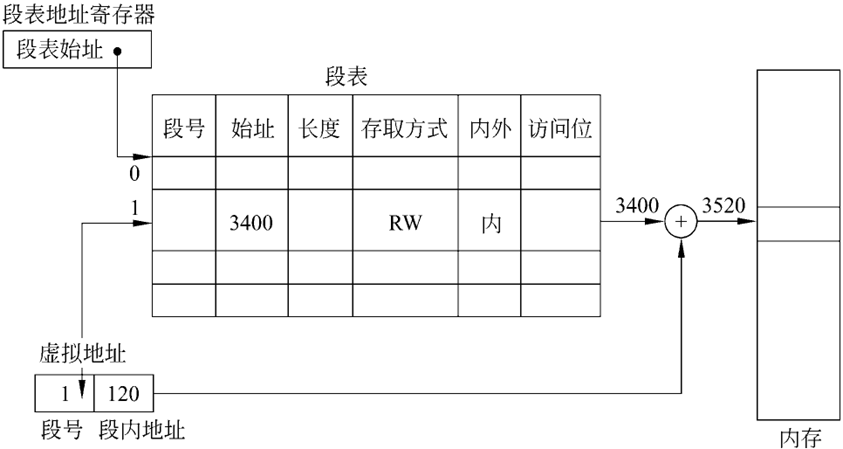
段式存储管理(考计算)

给定段表,计算逻辑地址对应的物理地址

image-20241212113915402
区别
页式管理 页是信息的物理单位,进行分页是出于系统管理的需要;页的大小是固定的。
段式管理 段是信息的逻辑单位,分段是出于用户的需要 ;段的大小是可变的。

页面置换算法(考)

注意刚开是空页放入也计入表格

FIFO算法:淘汰最早建立的页面,Belady现象

LRU:最近最久没有使用,当需要淘汰时,应淘汰当前时间最近的一段时间内最久没有使用过的页

LFU:最不经常使用,淘汰被访问次数最少的页

NUR:当需要淘汰某一页时,从那些最近一个时期内未被访问的页中任选一页淘汰

理想型页面置换法(OPT):选择“未来不再使用的”或“在离当前最远位 置上出现的”页面被置换

缺页率的计算:缺页次数/访问页面次数

Belady现象

采用FIFO算法时,如果对一个进程未分配它所要求的全部页面,有时就会出现分配的页面数增多,缺页率反而提高的异常现象。

原因:

FIFO算法的置换特征与进程访问内存的动态特征是矛盾的,即被置换的页面并不是进程不会访问的

局部性原理

指程序在执行过程中的一个较短时期,所执行的指令地址和指令的操作数地址,分别局限于一定区域

还可以表现为:

时间局部性,即一条指令的一次执行和下次执行,一个数据的一次访问和下次访问都集中在一个较短时期内;

空间局部性,即当前指令和邻近的几条指令,当前访问的数据和邻近的数据都集中在一个较小区域内

内存抖动问题

定义:

在虚存中,页面在内存与外存之间频繁调度,以至于调度页面所需时间比进程实际运行的时间还多,此时系统效率急剧下降,甚至导致系统崩溃。这种现象称为颠簸或抖动

产生的原因

分配给进程的物理页面数太少

页面淘汰算法不合理

避免的方法

扩大工作集

选择不同的淘汰算法

文件系统

文件的逻辑结构与存取方法

逻辑结构

字符流式的无结构文件:源程序、可执行文件、库函数等

记录式的有结构文件:数据库

存取方法

(1)顺序存取法

⑵ 随机(直接)存取法

⑶ 按关键字存取法

文件的物理结构与存储设备

物理结构

为了有效地管理文件存储器,通常把文件存储空间划分成若干个大小相等的物理块,物理块是分配及传输信息的基本单位

常用的物理结构:连续文件,串联文件,索引文件;

存储设备

顺序存储设备:磁带

直接存储设备:磁盘

磁盘臂调度算法

先来先服务(FCFS):

磁盘驱动程序每次接收一个请求并按照接收顺序完成请求

最短寻道时间优先(shortest seek time first,SSTF):

下一次总是处理与磁头距离最近的请求以使寻道时间最小化

文件空间管理

空闲文件目录

空闲块链

UNIX中使用成组链法

位视图

文件接口

OPEN, close, create,delete

目录结构

单级目录

结构简单,实现容易

搜索速度较慢,不允许文件重名

二级目录

解决了文件的重名问题和文件共享问题

提高搜索速度,查找时间降低

多级目录

层次结构清晰,便于管理和保护;有利于文件分类;解决重名问题;

查找一个文件按路径名逐层检查,由于每个文件都放在外存,多次访盘影响速度

文件的共享

绕道法

使用绕道法进行文件共享时,用户从当前目录出发向上返回到与所要共享文件所在路径的交叉点再顺序下访到共享文件

链接法

在相应目录表之间进行链接。即将一个目录中的链指针直接指向被共享文件所在的目录

基本文件目录表BFD

把所有文件目录的内容分成两部分:

基本文件目录表BFD:存放除了文件名之外的文件说明信息和文件内部标识符;

符号文件目录表SDF:存放文件名和文件内部标识符

存取权限控制

(1)文件的共享:指不同的用户共同使用一个文件

(2)文件的保护:指文件本身需要防止文件的拥有者或其他用户破坏文件内容。

(3)文件的保密:指未经拥有者许可,任何用户不得访问该文件。(防止窃取)

设备管理

SPOOLNG系统

假脱机真联机技术:设备管理的虚拟技术

它使用直接存取的大容量磁盘作为缓冲,将一个可共享的磁盘空间改造成若干个输入设备和输出设备,并使得I/O设备和CPU并行操作。(在联机情况下实现的同时外围操作)
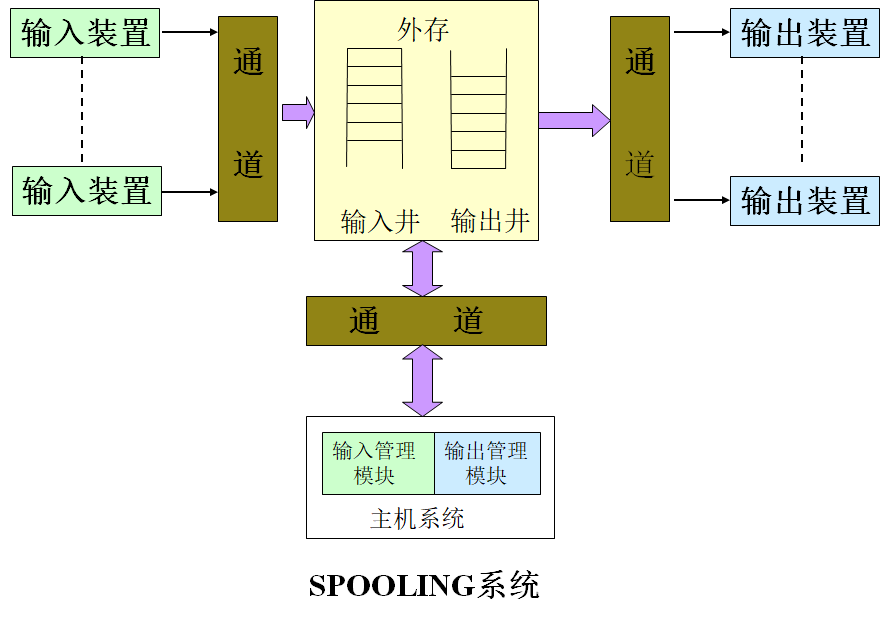
image-20241211203737885SPOOLING 系统的组成

(1)输入井和输出井(2)输入缓冲区和输出缓冲区

(3)输入进程和输出进程(输入管理模块、输出管理模块)

特点:

  1. 提高了I/O速度

    从对低速I/O设备进行的I/O操作变为对输入井或输出井的操作,如同脱机操作一样,提高了I/O速度,缓和了CPU与低速I/O设备速度不匹配的矛盾

  2. 设备并没有分配给任何进程

    在输入井或输出井中,分配给进程的是一存储区和建立一张I/O请求表.

  3. 实现了虚拟设备功能

    多个进程同时使用一独享设备,而对每一进程而言,都认为自己独占这一设备,不过,该设备是逻辑上的设备

数据传输控制方式

程序直接控制:由用户进程来直接控制内存或CPU和外设间的信息传送。

中断方式:进程通过CPU发出指令启动外设,该进程阻塞。当输入完成时,I/O控制器通过中断请求线向CPU发出中断信号,CPU进行中断处理。

DMA方式:在外设和内存之间开辟直接的数据交换通路。(成块)

通道控制方式:CPU发出启动指令,指出通道相应的操作和I/O 设备,该指令就可启动通道并使该通道从内存中调出相应的通道指令执行。(成组)

中断技术

中断的概念

指CPU对系统发生的某个事件作出的一种反应:

CPU暂停正在执行的程序,

保留现场后自动转去执行相应的处理程序,

处理完该事件后再返回断点继续执行被“打断”的程序。

中断的处理过程

1、保存被中断程序的现场,其目的是为了在中断处理完之后,可以返回到原来被中断的地方继续执行;

2、分析中断源,判断中断原因;

3、转去执行相应的处理程序;

4、恢复被中断程序现场,继续执行被中断程序。

分类

根据中断源的产生的条件,可把中断分为外中断和内中断

中断和陷阱的主要区别

将中断源按照外界因素的作用程度进行划分,常可分为自愿型中断与强迫型中断两大类

区别
中断 85657902ab75540595b752303f0eb1d强迫型中断
陷阱 2876e996378f11d2051d0611885b93b自愿型中断

缓冲技术

引入缓冲技术的原因

1、改善CPU与I/O设备间速度不匹配的矛盾

2、可以减少对 CPU的中断频率,放宽对中断响应时间的限制

3、提高 CPU和 I/O设备之间的并行性

缓冲的设置

根据位置:专用硬件缓冲器,软件缓冲

根据个数:单缓冲、双缓冲和缓冲池

设备分配数据结构
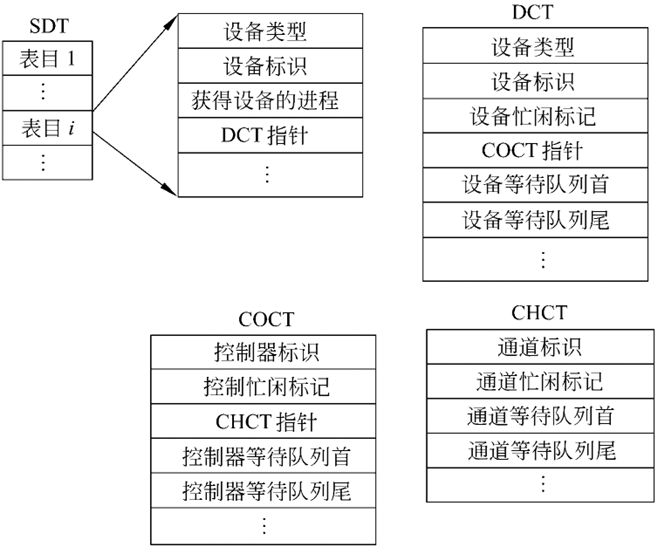
image-20241212120917660

设备无关性

为了提高系统的可适应性和可扩展性,我们希望所编制的用户程序与实际使用的物理设备无关,这就是所谓与设备无关性。

为此,我们将逻辑设备与物理设备区分,并引入逻辑设备名称和物理设备名称的概念

为了实现与设备的无关性,系统中必须有一张联系逻辑设备名称和物理设备名称的映射表,(LUT表)
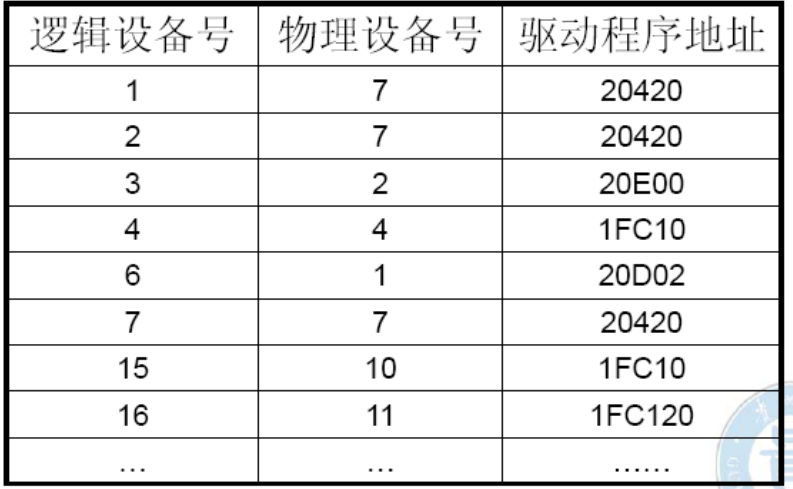
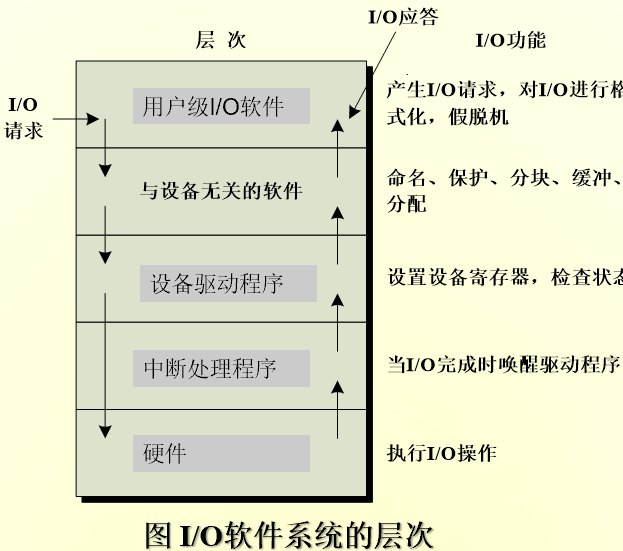
image-20241212121212267 image-20241212121304673

用户I/O:用户程序通过内核提供的系统调用接口与逻辑I/O层交互

设备无关程序

对设备驱动程序的统一接口——向用户层软件提供一个一致接口

设备命名——设备无关软件负责将设备名映射到相应驱动程序

设备保护——检查是否有权访问申请的设备(个人计算机不提供任何保护)

提供独立于设备块大小——逻辑记录到物理记录的转换

缓冲区管理与块设备的存储分配

独占性外围设备的分配和释放——通过 OPEN 打开相应的设备文件进行申请;关闭独占设备同时将释放该设备

错误报告——关键系统数据结构出错(如读磁盘使用状况位图),操作系统打印出错信息,并终止运行

设备驱动程序的功能

(1) 接收由I/O进程发来的命令和参数,并将命令中的抽象要求转换为具体要求,例如,将磁盘块号转换为磁盘的盘面、磁道号及扇区号。 

(2) 检查用户I/O请求的合法性,了解I/O设备的状态,传递有关参数,设置设备的工作方式。

(3) 发出I/O命令,如果设备空闲,便立即启动I/O设备去完成指定的I/O操作;如果设备处于忙碌状态,则将请求者的请求块挂在设备队列上等待。 

(4) 及时响应由控制器或通道发来的中断请求,并根据其中断类型调用相应的中断处理程序进行处理。

(5) 对于设置有通道的计算机系统,驱动程序还应能够根据用户的I/O请求,自动地构成通道程序。

I/O中断处理程序

通知用户程序输入输出操作推进的程度

通知用户程序输入输出操作正常结束(设备通知通道/控制器→CPU)

通知用户程序发现的输入输出操作异常,及提前中止操作的原因

通知程序外围设备上有重要的异步信号,如设备报到、设备结束等

LINUX操作系统

Linux进程调度原则:

按照进程优先级,调度最高优先级进程

进程优先级随时间动态变化

Linux的进程分为普通进程和实时进程

对于普通进程采用可抢占式动态优先级调度:SCHED_OTHER

对于实时进程,采用两种调度策略:

基于优先级(rt-priority)的先进先出调度:SCHED_FIFO,

基于优先级(rt-priority)的时间片轮转调度:SCHED_RR

Linux系统采用段页式存储管理技术,提供虚拟存储功能

补充

管程

是一种共享的数据结构,内部资源只能由内部函数访问,

基本特征:

各外部进程/线程只能通过管程提供的特定入口才能访问共享数据,

每次仅允许一个进程在管程内执行某个内部进程
Github配置ssh key

新增 SSH 密钥到 GitHub 帐户 - GitHub 文档

第一步
1
2
3
cd ~/.ssh
ls
//看是否存在 id_rsa 和 id_rsa.pub文件,如果存在,说明已经有SSH Key
第二步:生成ssh key

如果不存在ssh key,使用如下命令生成

1
2
ssh-keygen -t rsa -C "xxx@xxx.com"
//执行后一直回车即可
第三步:获取ssh key公钥内容(id_rsa.pub)
1
2
cd ~/.ssh
cat id_rsa.pub

复制该内容

第四步:Github账号上添加公钥

进入Settings设置
添加ssh key,把刚才复制的内容粘贴上去保存即

第五步:验证是否设置成功
1
ssh -T git@github.com

注意之后在clone仓库的时候要使用ssh的url,而不是https!

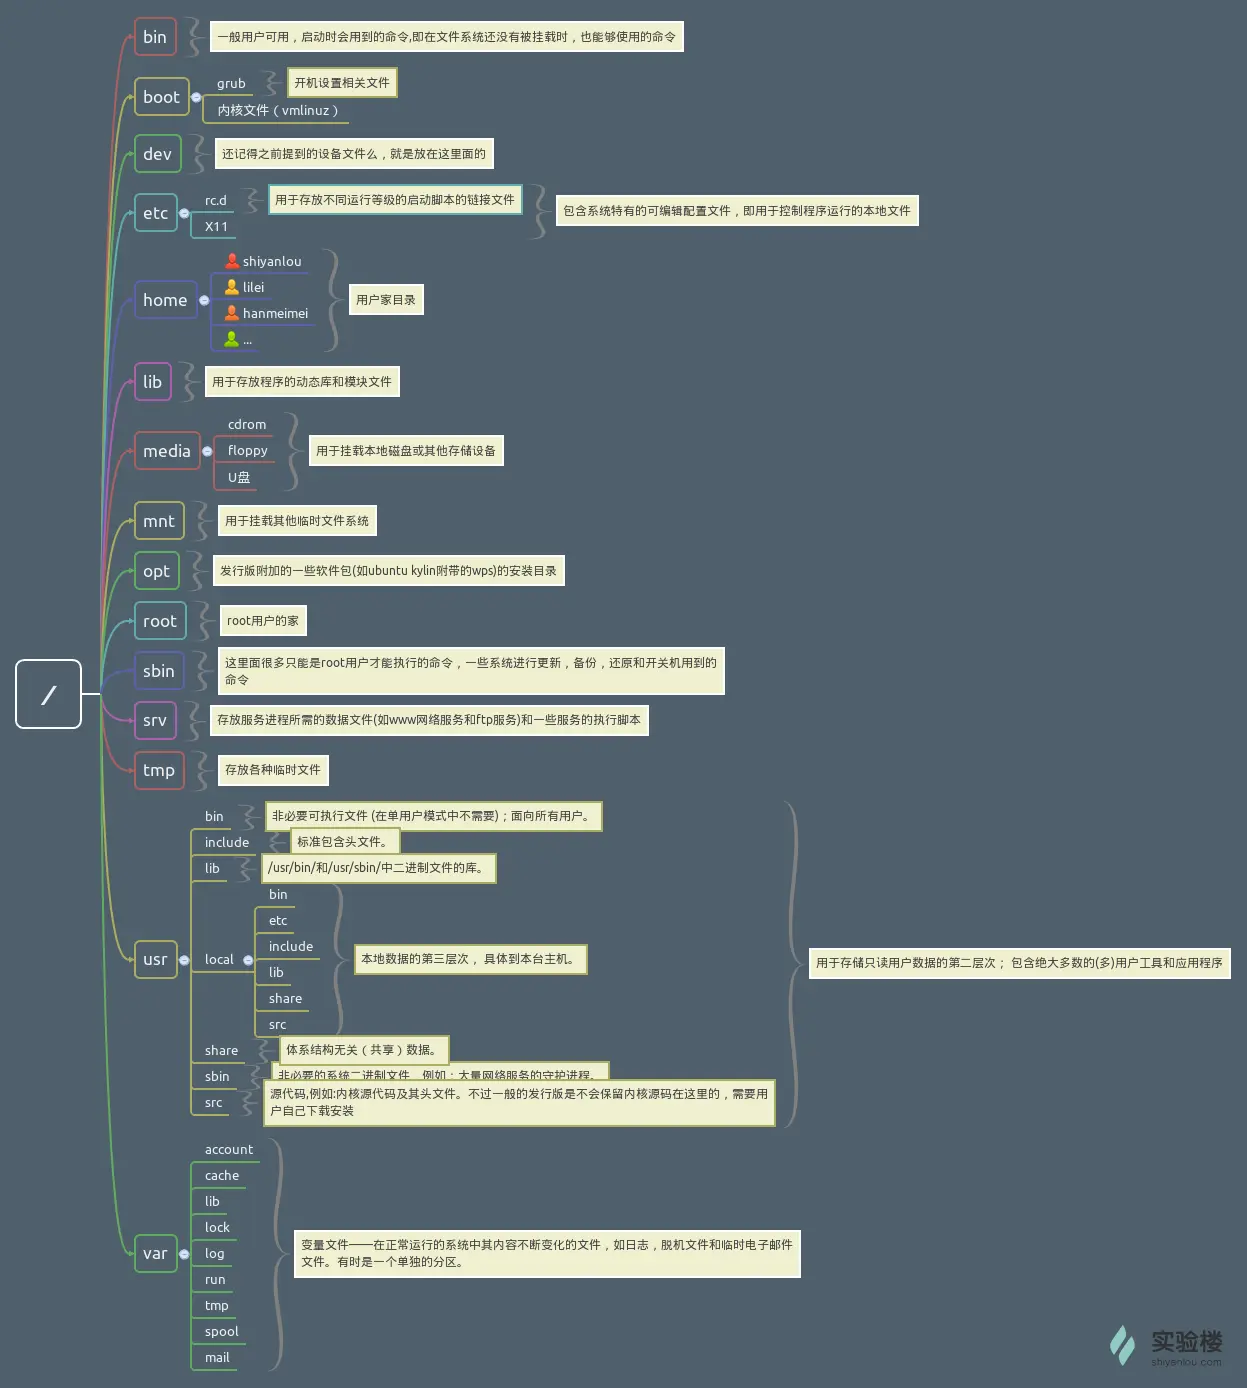
linux文件系统

Mysql问题

说一说事物隔离级别

SQL标准的事务隔离级别包括:

读未提交,读提交,可重复读,串行化

事务的四大特性有哪些?

原子性,一致性,隔离性,持久性

Linux系统目录

目录2

C++11新特性总结

C++11新特性总结

final关键字

使派生类不可覆盖它所修饰的虚函数

override描述符

如果派生类在虚函数声明时使用了override描述符,那么该函数必须重载其基类中的同名函数

关于左值,右值

C++中所有的值都必然属于左值、右值二者之一。左值是指表达式结束后依然存在的持久化对象,右值是指表达式结束时就不再存在的临时对象。所有的具名变量或者对象都是左值,而右值不具名。很难得到左值和右值的真正定义,但是有一个可以区分左值和右值的便捷方法:看能不能对表达式取地址,如果能,则为左值,否则为右值。

右值引用

左值是指可以出现在=左侧者,

右值是指只能出现在=右侧者

临时对象是个右值

右值引用与move语义的关系
  • 关联性: 右值引用是实现move语义的基础
  • 作用: 允许”偷取”临时对象的资源而非复制
  • 应用场景: 容器操作中大量临时对象的处理

移动语义

右值则临时对象

1
c.insert(ite,Vtype(buf));

左值则使用move关键字

1
2
M c1(c);
M c2(std::move(c1));
  • 核心机制
    • 当赋值右侧是右值时,左侧对象可直接”偷取”资源
    • 避免不必要的资源分配和拷贝
  • 实现要点
    • 类需要同时实现拷贝和移动语义版本
    • 移动操作后原对象应处于有效但未定义状态
    • 容器需要支持右值版本的插入操作
  • 注意事项
    • 被移动后的对象不应再使用
    • 移动构造函数应标记为noexcept
    • 临时对象自动被视为右值
  • 典型应用
    • 容器扩容时的元素迁移
    • 返回临时对象的优化
    • 明确不再使用的左值资源转移

应用

  1. 函数返回值优化。
  2. STL 容器的高效插入与操作。
  3. 动态资源管理(如智能指针)。

完美转发